

Jakiś czas temu internet obiegły zrzuty ekranu przedstawiające pytanie zadane do LLM-a: ile liter „r” jest w słowie „strawberry”. Modele odpowiadały, że dwie. Pewnie, bez cienia wahania i co najważniejsze: błędnie. Dzisiaj jesteśmy bogatsi o tę „wiedzę”, więc powtórzenie tego eksperymentu daje zupełnie inne wyniki.
Możesz zadać sobie całkiem uzasadnione pytanie. Dlaczego tak się działo? Odpowiedź na nie wynika po prostu z matematyki. Musisz wiedzieć, że model nigdy tych liter nie zobaczył!
Zanim Twoja wiadomość do niego dotrze, tekst zostaje pocięty na kawałki i zamieniony na liczby. „strawberry” idzie do modelu jako jeden kawałek – jeden token, bez „środka” i bez liter w środku. Pytanie o literę „r” jest z jego perspektywy jak proszenie kogoś o policzenie ziaren w bochenku chleba. Chleb powstał z ziaren, ale ziarna już nie istnieją.
Przejdziemy przez cztery rzeczy: co model widzi zamiast liter, jak „rozumie” znaczenie słów, skąd bierze kolejne słowo w odpowiedzi i co dokładnie pamięta.
Każdy przykład, omówimy na działającym kodzie, który możesz uruchomić u siebie.
Model nie widzi liter, widzi tokeny
Zacznijmy od podstawowej rzeczy, która może nieco zmienić Twoje dotychczasowe myślenie o tym, jak działa „AI”. Model nie operuje na tekście. Operuje na liczbach.
Zamiana tekstu na liczby to tokenizacja. Token bywa całym słowem, bywa fragmentem słowa, bywa samym znakiem interpunkcyjnym. Podział nie jest arbitralny, wynika ze statystyki: częste ciągi znaków dostają własny token, a rzadkie są sklejane z kawałków.
Zobaczmy to w kodzie
UWAGA: Do uruchomienia opisanych przykładów, prawdopodobnie będziesz potrzebował doinstalować kilka pakietów. Uruchom w terminalu: pip install sentencepiece. Na ten moment, klucz API do zewnętrznego dostawcy LLM-a nie jest potrzebny, bo liczenie tokenów odbywa się w całości na Twoim komputerze.
Na początek jedna rzecz, która przyda się w każdym kolejnym przykładzie. „Tokenizator”, który będziemy używać trzeba pobrać z repozytorium Google (około 4 MB).
curl -L -o tokenizer.model \
  "https://raw.githubusercontent.com/google/gemma_pytorch/cb7c0152a369e43908e769eb09e1ce6043afe084/tokenizer/gemma3_cleaned_262144_v2.spiece.model"
Ten adres możesz równie dobrze wkleić do przeglądarki. Pobierz dostępny artefakt i zapisz go w tym samym katalogu, z którego będziesz uruchamiać skrypty z artykułu.
W repozytorium plik nazywa się gemma3_cleaned_262144_v2.spiece.model. Przełącznik -o zapisuje go u Ciebie pod krótszą nazwą tokenizer.model, żeby nie ciągnąć jej przez cały kod. Wszystkie tokenizatory, jakie Google publikuje w tym repozytorium, obejrzysz na GitHubie. Starszy tokenizer.model ze słownikiem 256 000 pozycji obsługuje modele Gemma 1 i 2, a wyniki mogą wyjść na nim nieco inne.
Aby wszystko było jasne, muszę jeszcze doprecyzować, że pobrany tokenizator to tokenizator Gemmy, czyli otwartej rodziny modeli Google, a nie tokenizator Gemini. Tego drugiego Google nie publikuje jako pliku do pobrania. Nie ważne, z jakiego tokenizatora korzystasz. Liczby są tego samego rzędu i do zrozumienia mechanizmu w zupełności wystarczą, ale nie traktuj ich jako dokładnego rachunku za Gemini. Jeśli liczysz koszty, sumę potwierdź wywołaniem count_tokens po API (w tym przypadku dla tej funkcji jest wymagany płatny plan).
Zaczynamy od stworzenia pliku tokenizator.py:
# tokenizator.py
import sentencepiece as spm

kodek = spm.SentencePieceProcessor(model_file="tokenizer.model")Teraz właściwy przykład. Zwróć uwagę, że nigdzie nie ma tu wywołania sieciowego ani klucza API, bo cała robota dzieje się na Twoim komputerze:
# tokeny.py
from tokenizator import kodek #odowolujemy sie do kodeka z wczesniej utworzonego pliku tokenizator.py

for tekst in ["truskawka", "strawberry", "SELECT * FROM klienci"]:
    ids = kodek.encode(tekst)
    czesci = [kodek.id_to_piece(i).replace("▁", " ") for i in ids]
    print(f"{tekst!r}")
    print(f"  tokenów: {len(ids)}")
print(f" podział: {czesci}")Uruchom i popatrz na wynik. Angielskie słowo „strawberry” ma spore szanse zmieścić się w mniejszej ilości tokenów, niż jego polski odpowiednik „truskawka”, które jest dłuższe. Modele były trenowane raczej na języku angielskim, więc w danych treningowych angielski wyraz występował miliony razy.
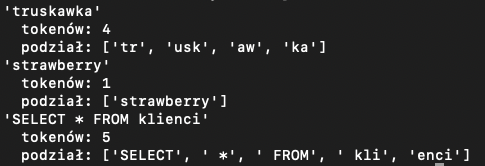
UWAGA: Liczby zależą od dostawcy. Każdy model ma własny tokenizator, więc to samo zdanie wypada inaczej u każdego z nich:
- Google (Gemini, Gemma): plik SentencePiece użyty wyżej, słownik 262 144 pozycje, pochodzący z Gemma 3. Tokenizatora samego Gemini Google nie publikuje jako pliku, więc lokalnie jest to najbliższy dostępny zamiennik, ale nie ten sam kodek. Jeśli liczysz koszty, potwierdź sumę wywołaniem
count_tokenspo API. Starsze modele Gemma 1 i 2 mają własny plik ze słownikiem 256 000 pozycji i dają inne liczby. - OpenAI (GPT): biblioteka
tiktoken, kodeko200k_basedla nowszych modeli,cl100k_basedla starszych. Liczy lokalnie i nie wymaga klucza. - Anthropic (Claude): tokenizator nie jest publikowany jako plik. Liczbę tokenów sprawdzisz endpointem
count_tokensw API, czyli potrzebujesz klucza. - Modele otwarte (Llama, Mistral, Qwen): tokenizator leży w repozytorium modelu na Hugging Face, wczytasz go przez
transformers.
Dlaczego to Ciebie dotyczy
Z tego jednego mechanizmu wynikają trzy praktyczne konsekwencje.
Model „nie umie” policzyć liter, bo nie ma do nich dostępu. Dostał kilka tokenów i żaden z nich nie mówi „tutaj jest r”. To trochę jak proszenie kogoś o policzenie ziaren w bochenku chleba. Chleb powstał z ziaren pszenicy, ale ziarna już nie istnieją.
Jeśli chcesz zobaczyć drugą stronę medalu, spójrz na kod, w którym tekst jest naprawdę tablicą znaków. Opisywałem to w artykule o tablicy typu char i o wczytywaniu znak po znaku. W językach programowania masz pełną kontrolę nad każdym bajtem. Model tej kontroli nie ma i nigdy nie miał.
W tym przykładzie Polskie słowo „kosztuje” więcej niż jego angielski odpowiednik. Nie zawsze tak musi być. Pamiętaj jednak, że z dostawcami LLM rozliczamy się per token (lub per 1M tokenów). Przy pojedynczym pytaniu nie ma to znaczenia, przy przetwarzaniu tysiąca dokumentów już tak.
Ile tokenów tak naprawdę zużywasz?
Możemy to bardzo prosto zmierzyć:
# stosunek.py
from tokenizator import kodek

pl = "Zapytanie SELECT pobiera dane z tabeli i pozwala je filtrować."
en = "A SELECT query fetches data from a table and lets you filter it."

for etykieta, tekst in [("polski", pl), ("angielski", en)]:
    n = len(kodek.encode(tekst))
    print(f"{etykieta:<10} znaków: {len(tekst):>3}  tokenów: {n:>3}  "
f"znaków/token: {len(tekst)/n:.2f}")W wyniku powyższego skryptu interesuje Cię ostatnia kolumna, która mówi, ile znaków przypada na jeden token. Im wyższa wartość, tym efektywniej język jest kodowany. Angielski wypadnie lepiej, bo na nim tokenizator był uczony:

Trzy pojęcia, które łatwo pomylić
Zrobię tutaj krótką przerwę, trzy pojęcia, które często są mylone, a mają zupełnie inne znaczenie.
Liczba parametrów, czyli to „7B” albo „70B” w nazwie modelu. To rozmiar samego modelu, liczba wag, z których się składa. Decyduje o tym, ile pamięci zajmuje i jak dużo sprzętu potrzebuje. Nie ma nic wspólnego z tym, jak długi tekst przyjmie.
Liczba tokenów w zapytaniu. To rozmiar tego, co właśnie wysyłasz. Zmienia się przy każdym wywołaniu i za to płacisz.
Okno kontekstu. Maksymalna liczba tokenów, jaką model przyjmie w jednym wywołaniu. To limit, nie rozmiar modelu.
Można mieć mały model z dużym oknem kontekstowym i duży model z małym oknem kontekstowym. Te trzy liczby są niezależne, a ich pomieszanie prowadzi do twierdzeń w rodzaju „model 7B nie przyjmie długiego dokumentu”, które są po prostu nieprawdziwe.
Od tokenu do znaczenia, czyli embedding
Tokeny to numery w słowniku. Numer sam z siebie nie mówi nic o znaczeniu, dokładnie tak jak numer pracownika nie mówi nic o tym, czym dany pracownik się zajmuje. Znaczenie pojawia się na następnym poziomie.
Każdy token zostaje zamieniony na wektor, czyli listę kilkuset albo kilku tysięcy liczb. Ten wektor nazywamy embeddingiem. Kluczowa własność jest taka: słowa o podobnym znaczeniu mają wektory blisko siebie, a odległość między nimi liczymy geometrycznie.
Poniższy przykład wymaga biblioteki numpy oraz google-genai. Zainstalujesz je, wywołując polecenie: pip install numpy oraz pip install google-genai.
UWAGA: Aby uruchomić skrypt opisany niżej, wymagany jest klucz API. Gemini API Key można wygenerować oraz użyć w darmowym planie. Aby to zrobić, wejdź na stronę aistudio.google.com/apikey, zaloguj się kontem Google, kliknij Create API key. Skopiuj wartość.
Skopiowany klucz API możesz zapisać jako zmienną środowiskową.
macOS / Linux, na jedną sesję terminala:
export GEMINI_API_KEY="twoj-klucz"Na stałe, dopisz tę samą linię do pliku powłoki i przeładuj:
echo 'export GEMINI_API_KEY="twoj-klucz"' >> ~/.zshrc   # bash: ~/.bashrc
source ~/.zshrc
Sprawdzenie: echo ${GEMINI_API_KEY:+ustawiony}
Windows, PowerShell:
$env:GEMINI_API_KEY = "twoj-klucz"      # na jedną sesję
setx GEMINI_API_KEY "twoj-klucz"        # na stałe, potem otwórz nowe okno
Sprawdzenie: if ($env:GEMINI_API_KEY) { "ustawiony" }
Windows, cmd:
set GEMINI_API_KEY=twoj-klucz          :: na jedną sesję
setx GEMINI_API_KEY "twoj-klucz"       :: na stałe
Sprawdzenie: echo %GEMINI_API_KEY%
# podobienstwo.py
import numpy as np
from google import genai

klient = genai.Client()
zdania = [
    "Jak usunąć dane z tabeli w SQL?",
    "W jaki sposób wykasować rekordy z bazy?",
    "Przepis na sernik krakowski",
]

odp = klient.models.embed_content(model="gemini-embedding-001", contents=zdania)
wektory = [np.array(e.values) for e in odp.embeddings]

def cosinus(a, b):
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))

print(f"SQL vs baza:   {cosinus(wektory[0], wektory[1]):.3f}")
print(f"SQL vs sernik: {cosinus(wektory[0], wektory[2]):.3f}")Pierwsze dwa zdania nie mają wspólnego ani jednego istotnego słowa. „Usunąć” i „wykasować”, „tabela” i „baza”, „SQL” i „rekordy”. Mimo to podobieństwo wyjdzie wysokie, w przeciwieństwie do słowa „sernik” – które z SQL i bazami danych nie ma związku.
Cosinus mierzy kąt między wektorami: 1,0 to ten sam kierunek, 0 to prostopadłe, czyli brak związku.
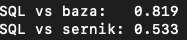
Pierwsza liczba, 0,819, mówi tyle: model uznał oba pytania za prawie to samo. I miał rację, bo pytają o to samo. A teraz spójrz na te zdania jeszcze raz. Nie łączy ich żadne wspólne słowo. Zwykłe wyszukiwanie po tekście nigdy by ich nie połączyło, bo porównuje znaki, a nie znaczenie!
Druga liczba wygląda niewinnie, ale jest ważniejsza. Sernik dostał 0,533, czyli ponad połowę. A przecież z SQL-em nie ma nic wspólnego.
Skąd aż tyle? Bo oba to polskie zdania. Podobna długość, podobna budowa, ten sam język. Model to widzi i samo z siebie podbija wynik. Przy embeddingach zero praktycznie nie występuje. To trochę jak porównywanie dwóch przypadkowych osób. Nawet zupełnie obcy ludzie mają dwie ręce i jedną głowę, więc zupełnej różnicy nigdy nie będzie.
Zapamiętaj więc jedno. Nie patrz na samą liczbę, patrz na różnicę między liczbami. Tutaj wynosi ona 0,286 i dopiero ona mówi, że pierwsze trafienie jest dobre, a drugie nie.
W praktyce znaczy to tyle, że progu nie ustawia się na oko. Gdybyś uznał, że trafieniem jest wszystko powyżej 0,5, sernik wskoczyłby na listę odpowiedzi o SQL-u.
Ile wynosi dobry próg? Na to pytanie nie da się odpowiedzieć jednoznacznie, sprawdzisz to wyłącznie pomiarem na własnych danych.
WDROŻENIE PRODUKCYJNE: Przykłady w tym artykule możemy uruchomić na darmowym API Google i to jest w porządku, bo pracujemy na kodzie i danych szkoleniowych. Do produkcji potrzebujesz płatnego planu, z dwóch powodów:
Po pierwsze, darmowy tier ma limity zapytań na minutę i dobę, które przy realnym ruchu skończą się błędem 429.
Po drugie i ważniejsze: dane wysyłane na darmowym tierze Google wykorzystuje do ulepszania swoich modeli, a płatny tier tego nie robi. Nie wysyłaj tam cudzych danych, kodu z prywatnego repozytorium ani niczego objętego umową z klientem. Warunki dostawców się zmieniają, więc sprawdź je przed wdrożeniem.
Pamiętaj, że embeddingi i liczenie tokenów wyglądają u każdego inaczej.
- OpenAI: embeddingi przez klienta biblioteki
openai, metodaembeddings.createz modelemtext-embedding-3-smallalbotext-embedding-3-large. Tokeny policzysz lokalnie bibliotekątiktoken, bez klucza i bez sieci. - Anthropic: nie ma własnego modelu embeddingowego i mówi to wprost w dokumentacji, kierując do zewnętrznego dostawcy Voyage AI. Do wyszukiwania semantycznego łączysz więc Claude z embeddingami skądinąd. Tokeny liczy się wywołaniem
client.messages.count_tokens, czyli po API i z kluczem. Anthropic nie publikuje tokenizatora jako pliku do pobrania, więc lokalnego odpowiednikatiktokennie ma.
To jest coś zupełnie innego niż LIKE
Tutaj chcę się zatrzymać, bo to najważniejsze rozróżnienie w całym artykule dla kogoś, kto do tej pory miał styczność z klasycznymi zapytaniami SQL.
LIKE '%usunąć%' dopasowuje znaki. Znajdzie „usunąć” i „usuwanie”, nie znajdzie „wykasować”. Nie ma pojęcia o znaczeniu, porównuje ciągi. Opisałem to swego czasu w artykule o operatorze LIKE i sortowaniu danych.
Embeddingi dopasowują położenie w przestrzeni znaczeń. Znajdą „wykasować”, choć nie mają z „usunąć” wspólnej litery.
LIKE jest precyzyjny, tani i przewidywalny. Embeddingi są przybliżone, kosztują wywołanie modelu i potrafią pomylić rzeczy, które tylko brzmią podobnie. Dobre systemy używają obu.
Warto też wiedzieć, że pomysł na sprowadzenie tekstu do liczb, na których da się coś policzyć, jest znacznie starszy od AI. Pisałem o tym przy okazji technik łamania szyfrów, gdzie analiza częstości znaków jest dokładnie taką operacją.
Skąd bierze się kolejne słowo?
Model robi jedną rzecz. Dla podanego ciągu tokenów przewiduje, jaki token jest najbardziej prawdopodobny jako następny. To wszystko. Cała reszta, całe wrażenie rozmowy, to powtarzanie tej jednej operacji.
Efekt nie jest jednak jedną odpowiedzią. Jest rozkładem prawdopodobieństwa nad całym słownikiem: ten token 41 procent, ten 12, ten 3 i tak dalej przez dziesiątki tysięcy pozycji.
Dlaczego powtórzone dwa razy to samo pytanie daje dwie różne odpowiedzi?
Bo z tego rozkładu trzeba coś wybrać, a wybór nie musi być zachłanny. Parametr temperatura decyduje, jak bardzo model może zejść z najbardziej prawdopodobnej ścieżki. Zero oznacza „bierz zawsze najwyższe prawdopodobieństwo”, wartości wyższe dopuszczają większą losowość.
Stąd praktyczna reguła. Do zadań, gdzie liczy się powtarzalność, czyli klasyfikacja, wyciąganie danych, generowanie kodu według sztywnego wzorca, ustawiaj temperaturę nisko. Do zadań, gdzie chcesz różnorodności, podnoś.
Koszt rośnie z kwadratem długości
Przy generowaniu każdego kolejnego tokenu model bierze pod uwagę relacje między wszystkimi tokenami, które już ma. Liczba par rośnie z kwadratem ich liczby. Podwójnie długie wejście oznacza czterokrotnie więcej pracy.
Jeśli chcesz odświeżyć wiedzę, dlaczego wykładnik przy N dość sporo zmienia, to mam o tym osobny wpis na temat złożoności obliczeniowej. Dla leniwych wystarczy zapamiętać jeden wniosek: długi kontekst nie jest darmowy nawet wtedy, gdy mieści się w limicie.
Okno kontekstu, czyli co model naprawdę pamięta
Model nie ma pamięci. Każde wywołanie to jak czyste białe płótno. Model nie pamięta poprzedniego pytania, nie pamięta Cię, nie pamięta niczego.
Wrażenie rozmowy powstaje, dlatego że aplikacja przy każdej wiadomości wysyła całą historię od nowa. Piąte pytanie w czacie to w rzeczywistości jedno wywołanie zawierające całą dotychczasową historię konwersacji, cztery odpowiedzi i nowe pytanie. Nic poza tym.
Maksymalna długość tego pakietu to okno kontekstu (context window). Podaje się je w tokenach.
Zmierz, ile okna kontekstowego zajmuje Twoja rozmowa
# budzet.py
from tokenizator import kodek

LIMIT = 8000  # ustaw zgodnie z modelem, którego używasz

historia = []

def dodaj(rola, tresc):
    historia.append({"role": rola, "content": tresc})
    zajete = sum(len(kodek.encode(w["content"])) for w in historia)
    procent = zajete / LIMIT * 100
    print(f"{zajete:>6} / {LIMIT} tokenów ({procent:.0f}%)  wiadomości: {len(historia)}")
    if procent > 75:
        print("  UWAGA: czas przyciąć historię")


dodaj("system", "Jesteś asystentem programisty. Odpowiadaj zwięźle.")
dodaj("user", "Napisz zapytanie SQL liczące zamówienia po miastach.")
dodaj("assistant", "SELECT miasto, COUNT(*) FROM zamowienia GROUP BY miasto")
dodaj("user", "A teraz to samo, ale tylko dla Krakowa i z sumą kwot.")Cztery wywołania na końcu pliku to przykładowa rozmowa.
Po uruchomieniu zobaczysz:
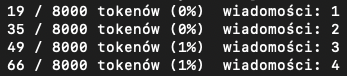
Każda linia to jedno wywołanie dodaj(), czyli jedna wiadomość dorzucona do rozmowy. Weźmy ostatnią z nich, 66 / 8000 tokenów (1%) wiadomości: 4, i rozłóżmy ją na części pierwsze.
66 to liczba tokenów, jaką zajmuje cała rozmowa w tym momencie. 8000 to limit, który sam ustawiasz w stałej LIMIT na górze pliku, zgodnie z modelem, którego używasz. 1% mówi, jaka część tego limitu jest już zajęta. Wiadomości: 4 to liczba wypowiedzi, które się na rozmowę składają.
Kluczowa jest pierwsza liczba i to, czego ona dotyczy. Nie mierzy ostatniej wiadomości, tylko wszystko naraz. Każde dodaj() dokłada jedną wypowiedź, ale w rzeczywistości przelicza całą historię od nowa. Dlatego wynik rośnie z linii na linię: 19, potem 35, potem 49, potem 66. Dokładnie tak wygląda rozmowa z modelem. Zadając czwarte pytanie, wysyłasz wszystkie poprzednie wiadomości jeszcze raz.
I stąd bierze się rzecz, która zaskakuje przy pierwszym poważniejszym rachunku. Rozmowa waży na końcu 66 tokenów. Jednak przez cztery tury wysłałeś do modelu 19 + 35 + 49 + 66, czyli 169 tokenów. Dwa i pół raza więcej, niż liczy sobie sama rozmowa, a mówimy o czterech krótkich zdaniach. Przy dwudziestu turach ten mnożnik idzie w kilkanaście. Nie płacisz za długość rozmowy, płacisz za sumę wszystkich jej kopii.
Co się dzieje przy przepełnieniu
Model nie zgłasza wtedy sensownego błędu i nie prosi o skrócenie. Zazwyczaj aplikacja po cichu wyrzuca najstarsze wiadomości, czytaj: przycina rozmowę. To drugie jest groźniejsze. Model po prostu przestaje „wiedzieć” o rzeczach, które ustaliliście na początku, i zaczyna sobie radzić po swojemu.
Więcej kontekstu nie znaczy lepiej
Rozmiary okien poszły ostatnio mocno w górę i łatwo z tego wyciągnąć wniosek, że skoro limity są tak duże, to warto wysyłać wszystko. W rzeczywistości jest zupełnie na odwrót.
Modele najlepiej wykorzystują początek i koniec podanego kontekstu, a w środku po prostu się gubią. Do tego dochodzi kwadratowy koszt. Wklejenie całego pliku, zamiast dwóch potrzebnych funkcji potrafi dać gorszą odpowiedź, generowaną dłużej i przy większym zużyciu tokenów.
Temat jest na tyle obszerny, że napiszę o nim osobno. Na razie zapamiętaj regułę: do kontekstu wpuszczaj to, co potrzebne do tego jednego zadania.
Skąd biorą się halucynacje
Wszystko z poprzednich sekcji składa się teraz w jedną odpowiedź na pytanie, które słyszę najczęściej.
Model nie ma stanu „nie wiem”. Zawsze zwraca najbardziej prawdopodobny ciąg tokenów. Jeśli pytasz o coś, czego nie ma w jego wiedzy ani w kontekście, nie odmawia. Generuje odpowiedź, która wygląda jak prawdziwa, bo dokładnie tego się nauczył: produkować tekst statystycznie podobny do prawdziwego.
Dlatego halucynacje najbardziej dotyczą Twoich własnych danych. Nazwy tabel w Twojej bazie, struktura Twojego repozytorium, treść Twojej faktury. Tego wszystkiego nie było w danych treningowych i nie ma w kontekście, jeśli sam tego nie dostarczysz.
Jak sobie z tym radzić?
Po pierwsze to dostarczenie danych w kontekście. Skoro model umie korzystać z tego, co dostanie w zapytaniu, wystarczy mu to dać. Najprościej przez narzędzia, którymi model sam sięga po dane, i o tym jest mój artykuł o serwerze MCP w praktyce. Gdy danych jest dużo i trzeba wybierać, wchodzi wzorzec RAG, do którego wrócę w osobnym wpisie.
Druga to dostrajanie modelu (fine-tuning), czyli douczenie go na własnym zbiorze. Brzmi kusząco i jest prawie zawsze złym pierwszym wyborem: kosztuje, wymaga danych, trzeba powtarzać przy każdej zmianie, a wiedza i tak się starzeje. Dostrajanie zmienia styl i format odpowiedzi. Do wstrzykiwania faktów służy kontekst.
O czym warto pamiętać przy pisaniu promptów?
Kontekst przed pytaniem. Model czyta ciąg od początku. Jeśli najpierw dostanie dane, a potem polecenie, to formułując odpowiedź, ma już wszystko na miejscu.
Powiedz wprost, jakiego wyjścia oczekujesz. Model przewiduje najbardziej prawdopodobną kontynuację. Przykładowo, wiadomość: „Zwróć JSON z polami nazwa i typ” jest znacznie węższą podpowiedzią niż „opisz to”, więc trafienie jest pewniejsze.
Jedno zadanie na wywołanie. Trzy zadania w jednym prompcie oznaczają, że model musi utrzymać trzy wątki w jednym rozkładzie prawdopodobieństwa. Trzy osobne wywołania są dokładniejsze i łatwiej je debugować.
Szybkie Q&A
„Model uczy się z naszej rozmowy”.
Nie w trakcie rozmowy. Wagi modelu są ustalone i nie zmieniają się od tego, co mu napiszesz. Wrażenie uczenia się w obrębie jednej sesji bierze się z historii wysyłanej za każdym razem. Po zamknięciu rozmowy nie zostaje z tego nic.
„Skoro pomylił się, poprawię go i będzie pamiętał”.
Będzie, ale tylko dopóki poprawka jest w kontekście. Po przycięciu historii wróci do pierwotnej wersji, bo nic w modelu się nie zmieniło. W nowej rozmowie tym bardziej, bo zaczyna ją od zera.
To jednak nie znaczy, że jesteś skazany na powtarzanie tej samej uwagi w kółko. Znaczy tylko, że poprawkę trzeba zapisać poza modelem, tam skąd narzędzie samo ją wczyta. Przykładowo: Claude Code czyta plik CLAUDE.md z katalogu projektu, Cursor swój plik z regułami, a ChatGPT ma instrukcje projektu i pamięć. Wpisz tam „w tym projekcie używamy PostgreSQL, nie MySQL”, a ta linijka pojedzie na początku każdej kolejnej rozmowy.
I tu jest cały haczyk, bo na zewnątrz wygląda to, jak uczenie się, a nie jest nim wcale. Wagi modelu ani drgnęły. Narzędzie po prostu dokleiło Twoją notatkę do kontekstu, zanim model cokolwiek zobaczył. Różnica jest praktyczna: taka notatka zajmuje tokeny w każdym wywołaniu i przestaje działać, gdy wypadnie z okna kontekstu przy długiej sesji.
Reguła, która z tego wynika: jeśli poprawka ma znaczenie tylko teraz, dopisz ją w czacie. Jeśli ma obowiązywać zawsze, zapisz ją w pliku, który narzędzie wczytuje.
„Model liczy”.
Nie liczy w sensie, w jakim liczy kalkulator. Przewiduje najbardziej prawdopodobny ciąg tokenów, a dla prostych działań ten ciąg zwykle jest poprawnym wynikiem, bo widział go miliony razy. Przy większych liczbach przestaje. Dlatego do liczenia daje się modelowi narzędzie, a nie zaufanie.
„Wyższa temperatura znaczy, że model jest bardziej kreatywny”.
Wyższa temperatura znaczy, że częściej wybiera tokeny o niższym prawdopodobieństwie. Przy zadaniach twórczych bywa to odbierane jako pomysłowość, a przy zadaniach na fakty jako błędy.
O czym nie napisałem?
Nie wspomniałem tutaj o trenowaniu modeli, bo to zupełnie inna dziedzina. Nie napisałem o architekturze wewnętrznej, czyli mechanizmie „uwagi” opisanego wzorami. Nie ma tutaj nic wspomnianego również o modelach multimodalnych.
To, co tu jest, wystarcza do sensownego korzystania z modeli w kodzie i nie zestarzeje się przy premierze kolejnej wersji. Tokeny zostaną tokenami, wektory wektorami.
Jeśli miałbym wskazać jedną rzecz z tego wszystkiego, która najbardziej zmienia sposób pracy z modelami, to nie byłaby to żadna technika. Byłoby to porzucenie myślenia o modelu jak o rozmówcy i przyjęcie, że jest funkcją: podajesz ciąg tokenów, dostajesz przewidywany ciąg tokenów. Wszystko pozostałe, od promptów po halucynacje, wynika z tego jednego zdania.
Wszystkie skrypty z artykułu razem z plikiem tokenizer.model, plikiem requirements.txt i krótkim README znajdziesz w jednej paczce:
Jeśli uruchomisz te skrypty u siebie na komputerze i coś Cię zaskoczy, daj znać w komentarzu! Masz pytania? Również zachęcam do dyskusji.

 Łukasz Dudziński2026-11-05 · 4 min
 Łukasz Dudziński2026-10-22 · 13 min
 Łukasz Dudziński2026-10-08 · 9 min
// brak komentarzy — bądź pierwszy