

Wyobraź sobie, że masz katalog z dwustoma dokumentami i pytanie: „która umowa dotyczy hostingu?”. Klasyczne LIKE '%hosting%' znajdzie pliki, w których wystąpił dokładnie ten sam ciąg znaków. Nie znajdzie umowy mówiącej o „utrzymaniu serwera”, choć to dokładnie ten dokument, którego szukasz.
RAG (ang. Retrieval Augmented Generation), czyli generowanie wzbogacone o wyszukiwanie, rozwiązuje dokładnie ten problem.
Zbudujemy to od zera, bez żadnego frameworka. Nie dlatego że frameworki są złe, ale po napisaniu tego samodzielnie zobaczysz, że pod spodem nie ma magii. Jest pętla, wektory i sortowanie.
Dlaczego stosujemy RAG?
Model językowy zna tylko to, co dostanie w zapytaniu. Twoich dokumentów nie widzi i nigdy nie widział. Pisałem o tym szerzej w artykule: Jak działa LLM.
Skoro model potrafi korzystać z tego, co dostanie, to problem sprowadza się do tego, aby „dokleić” do wiadomości taki kontekst, aby było on jak najmniejszy, a jednocześnie wystarczający. Przekładając to na nasz przykład, szukamy dopowiedzi na pytanie: jak wybrać dokładnie te dwa dokumenty z dwustu, które są istotne dla zadanego pytania?
RAG vs dostrajanie modelu
Naturalne jest pomyśleć „doszkolę model na swoich dokumentach”. Niestety, prawie zawsze to zły pomysł.
Dostrajanie (ang. fine-tuning) zmienia styl i format odpowiedzi, nie wstrzykuje faktów w sposób, na który możemy polegać. Kosztuje, wymaga przygotowanych danych i trzeba go powtarzać przy każdej zmianie dokumentów źródłowych. RAG działa od razu, a ewentualne modyfikacje obsłużysz przez mechanizm indeksowania.
RAG vs serwer MCP
RAG podaje modelowi treść. Ty decydujesz, co trafi do kontekstu, a nie model, który jest niedeterministyczny.
Serwer MCP daje modelowi narzędzia. Model sam decyduje, kiedy i po co ich użyć. Ten mechanizm opisałem dokładniej w artykule o serwerze MCP w praktyce.
Dla statycznego zbioru dokumentów lepszy jest RAG. Dla danych, które trzeba odpytywać na żywo, lepsze są narzędzia. Dla jednego i drugiego naraz używa się obu rozwiązań, i to jest zupełnie normalna architektura.
RAG w praktyce
Poznaliśmy już wstępną zasadę działania RAG oraz wiemy, czym ten mechanizm różni się od innych rozwiązań. Przejdźmy więc do jego praktycznego zastosowania.
Zanim zanurkujemy w kodzie, zobaczmy całość na jednym obrazku. Wrócisz tu pewnie kilka razy, bo każdy kolejny krok opisany w tym artykule, odpowiada jednemu klockowi z tego schematu.
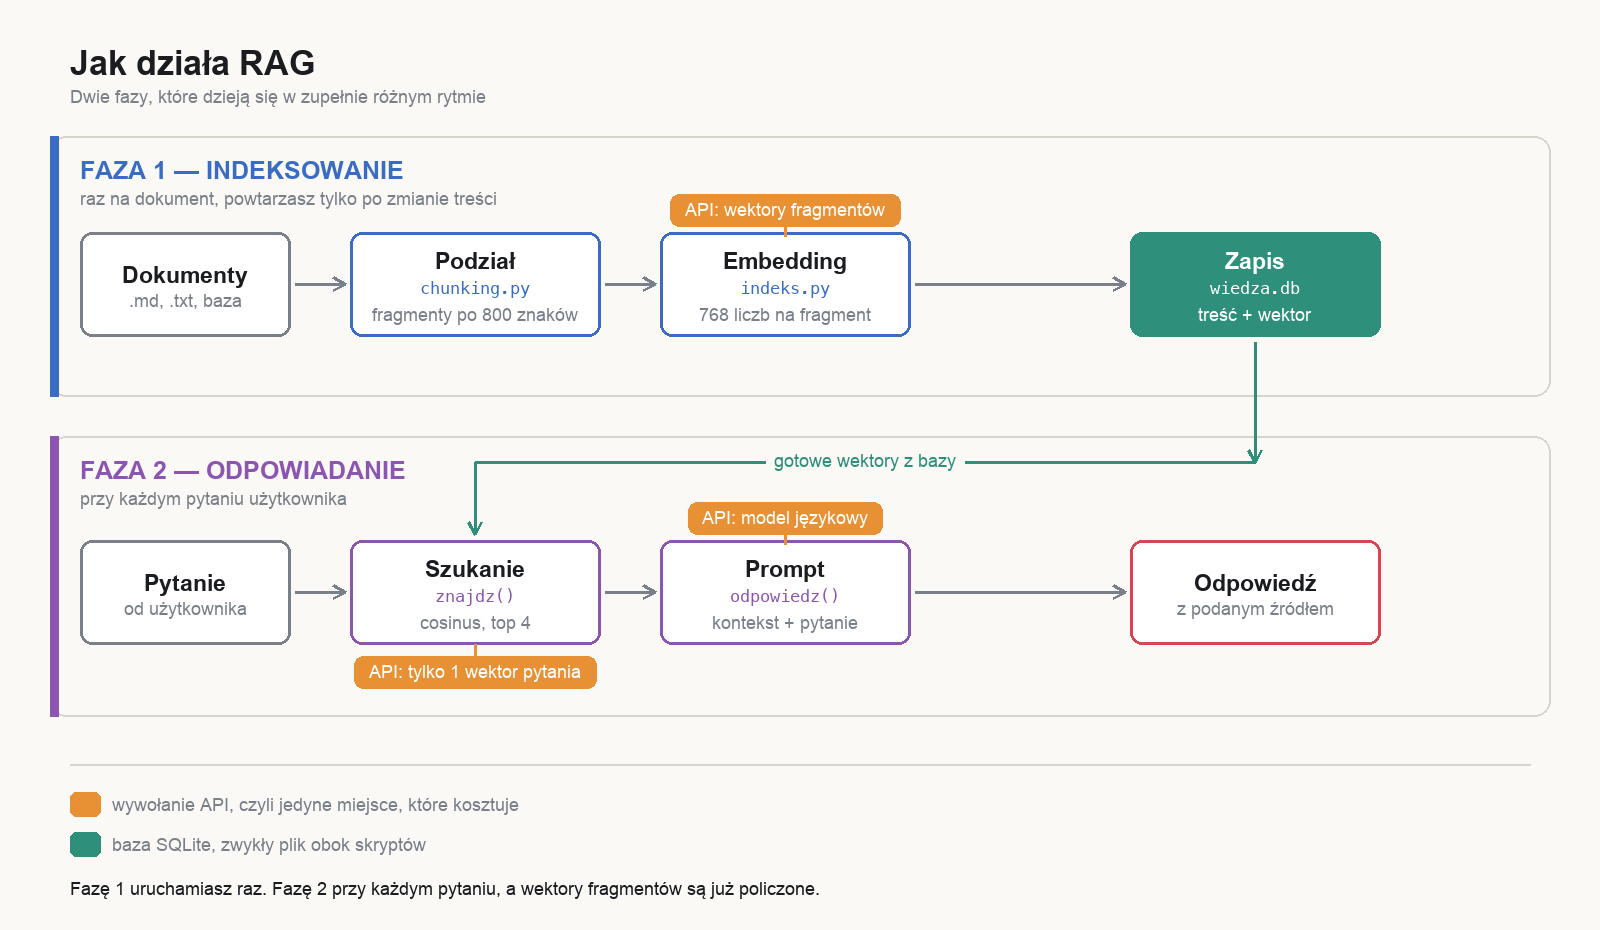
Najważniejsza rzecz na rysunku to podział na dwie fazy, dzieją się one w zupełnie różnym rytmie.
Faza pierwsza: indeksowanie, przygotowuje bazę wiedzy. Dokumenty dzielisz na fragmenty, każdy fragment zamieniasz na wektor, wszystko zapisujesz do bazy. Robisz to raz i powtarzasz tylko wtedy, gdy zmieni się treść dokumentu.
Faza druga: odpowiadanie, uruchamia się przy każdym pytaniu. Pytanie zamieniasz na wektor, porównujesz z tym, co już leży w bazie, najlepsze fragmenty wklejasz do promptu i pytasz model.
Zwróć uwagę na pomarańczowe znaczniki, pokazują one miejsca, w których ponosisz koszt u swojego dostawcy LLM. W fazie indeksowania liczysz wektory dla wszystkich fragmentów, ale tylko raz. W fazie odpowiadania liczysz jeden wektor, dla samego pytania, a fragmenty masz już policzone. To rozróżnienie decyduje o Twoim rachunku, jaki dostaniesz od dostawcy LLMa.
Dzielenie dokumentów, czyli chunking
Na samym początku, ważna informacja. Korzystając poprzez LLMa z RAG, nie możemy wrzucić do konwersacji całego dokumentu. Okno kontekstu jest ograniczone, a długi kontekst kosztuje i pogarsza jakość odpowiedzi. Aby tego uniknąć, dzielimy więc dokumenty na fragmenty, po angielsku chunks.
Trzy sposoby podziału
Najprostszy to podział po ustalonej liczbie znaków. Szybki, ale też zły. Może on przeciąć zdanie w połowie, co powoduje, że dany fragment traci sens.
Drugi to podział po strukturze dokumentu, czyli po akapitach albo nagłówkach. Zwykle najlepszy, bo autor już wykonał pracę logicznego pogrupowania treści.
Trzeci to podział po liczbie tokenów z zachowaniem granic zdań. Najbardziej przewidywalny przy pilnowaniu budżetu.
Te same trzy metody na jednym akapicie
Warto zobaczyć różnicę na konkretnym przykładzie, bo zły podział generuje słabe odpowiedzi.
Weźmy akapit umowy. Ma 203 znaki i 51 tokenów:
Okres wypowiedzenia wynosi trzy miesiące i liczony jest od pierwszego dnia miesiąca następującego po miesiącu, w którym złożono wypowiedzenie. Wypowiedzenie wymaga formy pisemnej pod rygorem nieważności.Metoda pierwsza: podział po ustalonej liczbie znaków
Ustawmy 80 znaków.
Rezultat:
- „Okres wypowiedzenia wynosi trzy miesiące i liczony jest od pierwszego dnia miesi”
- „ąca następującego po miesiącu, w którym złożono wypowiedzenie. Wypowiedzenie wym”
- „aga formy pisemnej pod rygorem nieważności.”
Zwróć uwagę, gdzie przebiegły cięcia. Nie na granicy zdania ani nawet słowa, tylko w środku wyrazów: „miesi” i „ąca”, „wym” i „aga”. Licznik doszedł do osiemdziesięciu znaków i zgodnie z założeniami, dokonał podziału.
Skutek jest taki, że pytanie o okres wypowiedzenia trafi na pierwszy fragment i dostaniesz niepełną, wprowadzającą w błąd informację, bo brakuje w niej sposobu liczenia.
Drugi fragment bez pierwszego jest bezużyteczny, a przy podobieństwie znaczeniowym wypadnie nisko, bo nie ma w nim kluczowych słów.
Trzeci zaczyna się od sylaby.
To jest największy minus RAG. Nie ma błędu, nie ma pustej wiadomości. Jest pewna odpowiedź, która z kolei jest oparta na połowie zdania.
Metoda druga: podział po strukturze dokumentu
To jeden akapit, więc zostaje w całości:
- „Okres wypowiedzenia wynosi trzy miesiące i liczony jest od pierwszego dnia miesiąca następującego po miesiącu, w którym złożono wypowiedzenie. Wypowiedzenie wymaga formy pisemnej pod rygorem nieważności.” (203 znaki)
Fragment jest spójny, bo autor tekstu, już wykonał pracę grupowania treści, a my tylko z niej skorzystaliśmy. To jest dokładnie ta metoda, którą implementuje funkcja podziel() w opisanych przykładach. Wada? Przy akapitach dłuższych niż ustalony limit długości fragmentu, taki akapit trzeba jakoś przyciąć.
Metoda trzecia: podział po liczbie tokenów z zachowaniem granic zdań
Ustawmy budżet 40 tokenów na fragment:
- „Okres wypowiedzenia wynosi trzy miesiące i liczony jest od pierwszego dnia miesiąca następującego po miesiącu, w którym złożono wypowiedzenie.” (33 tokeny)
- „Wypowiedzenie wymaga formy pisemnej pod rygorem nieważności.” (18 tokenów)
Cięcie wypadło na kropce, więc oba fragmenty są zdaniami zamkniętymi i każdy da się zrozumieć osobno. Jednocześnie żaden nie przekracza budżetu, który sam ustaliłeś. Dlatego ta metoda jest najbardziej przewidywalna, gdy pilnujesz kosztów.
Uwaga: W naszym przykładzie podział metodą po liczbie tokenów dał całkiem sensowne rezultaty. Weź jednak pod uwagę, że jest to po prostu PRZYPADEK i nie zawsze tak musi być.
Liczba fragmentów sama w sobie nic nie mówi. Znaczenie ma to, czy każdy z nich da się przeczytać bez pozostałych.
# chunking.py
import re

def podziel_po_znakach(tekst, max_znakow=800):
    """METODA 1. Tnie co N znaków, nie patrząc na treść.
    Szybka, przewidywalna i potrafi przeciąć wyraz w połowie."""
    return [tekst[i:i + max_znakow] for i in range(0, len(tekst), max_znakow)]

def podziel(tekst, max_znakow=800, zachodzenie=150):
    """METODA 2. Dzieli tekst po akapitach, nie przecinając ich w środku.
    Zachodzenie przenosi ogon poprzedniego fragmentu do następnego."""
    akapity = [a.strip() for a in re.split(r"\n\s*\n", tekst) if a.strip()]
    fragmenty, biezacy = [], ""

    for akapit in akapity:
        if len(biezacy) + len(akapit) + 2 <= max_znakow:
            biezacy = f"{biezacy}\n\n{akapit}".strip()
        else:
            if biezacy:
                fragmenty.append(biezacy)
            ogon = biezacy[-zachodzenie:] if zachodzenie and biezacy else ""
            biezacy = f"{ogon}\n\n{akapit}".strip() if ogon else akapit

    if biezacy:
        fragmenty.append(biezacy)
    return fragmenty

def podziel_po_tokenach(tekst, max_tokenow=200, tokenizator="tokenizer.model"):
    """METODA 3. Pakuje całe zdania, aż do wyczerpania budżetu tokenów.
    Wymaga: pip install sentencepiece oraz pliku tokenizer.model.
    Skąd go wziąć, opisuję w artykule o tym, jak działa LLM."""
    import sentencepiece as spm

    kodek = spm.SentencePieceProcessor(model_file=tokenizator)
    zdania = re.split(r"(?<=[.!?])\s+", tekst)
    fragmenty, biezacy = [], ""

    for zdanie in zdania:
        kandydat = f"{biezacy} {zdanie}".strip()
        if len(kodek.encode(kandydat)) <= max_tokenow:
            biezacy = kandydat
        else:
            if biezacy:
                fragmenty.append(biezacy)
            biezacy = zdanie

    if biezacy:
        fragmenty.append(biezacy)
    return fragmenty

if __name__ == "__main__":
    UMOWA = (
        "Okres wypowiedzenia wynosi trzy miesiące i liczony jest od pierwszego "
        "dnia miesiąca następującego po miesiącu, w którym złożono wypowiedzenie. "
        "Wypowiedzenie wymaga formy pisemnej pod rygorem nieważności."
    )

    def pokaz(tytul, fragmenty):
        print(f"\n{tytul}")
        for i, f in enumerate(fragmenty, 1):
            print(f"  {i}. [{len(f):>3} zn] {f}")

    print(f"Tekst wejściowy: {len(UMOWA)} znaków")
    pokaz("METODA 1, po 80 znakach:", podziel_po_znakach(UMOWA, 80))
    pokaz("METODA 2, po strukturze:", podziel(UMOWA))
    try:
        pokaz("METODA 3, budżet 40 tokenów:", podziel_po_tokenach(UMOWA, 40))
    except (ImportError, OSError) as blad:
        print(f"\nMETODA 3 pominięta: {blad}")
        print("  Potrzebne: pip install sentencepiece oraz plik tokenizer.model")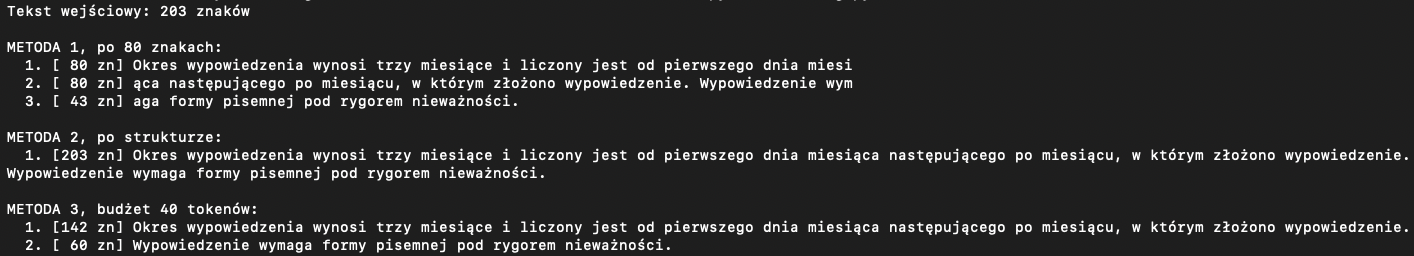
Zachodzenie fragmentów
W powyższym przykładzie mamy parametr, który łatwo przeoczyć: zachodzenie=150. To domyślne ustawienie, więc działa u Ciebie od pierwszego uruchomienia kodu, a robi rzecz, która na pierwszy rzut oka wygląda na błąd. Celowo zapisuje ten sam tekst w dwóch sąsiednich fragmentach.
Powód widać dopiero wtedy, gdy zdanie ważne dla odpowiedzi wypada dokładnie na granicy podziału:
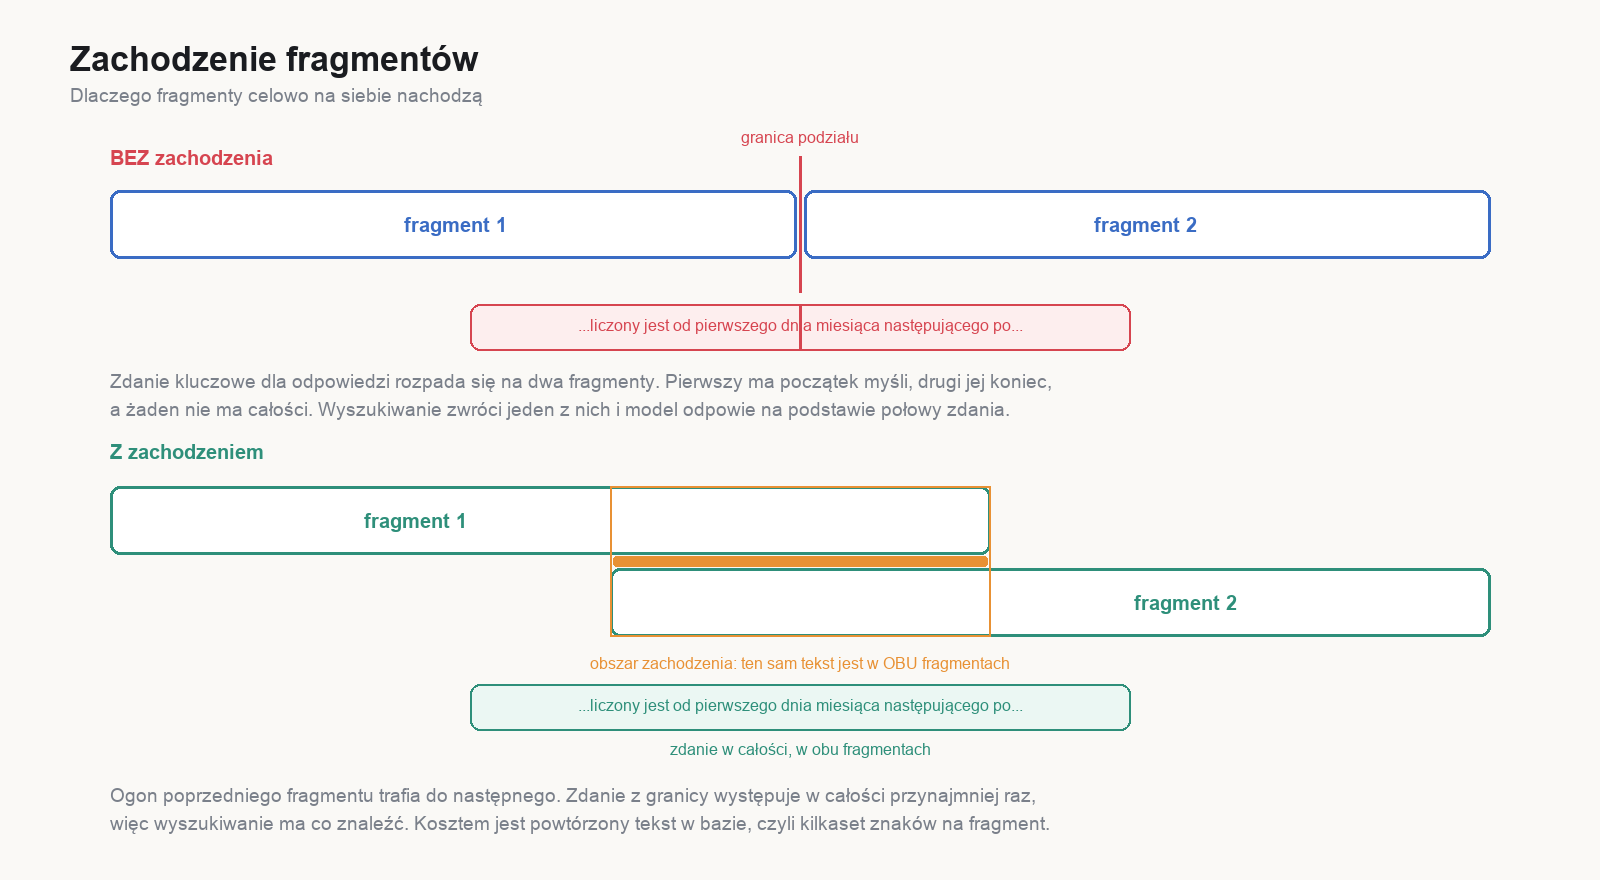
Bez zachodzenia pierwszy fragment ma początek myśli, drugi jej koniec, a żaden nie ma całości. Wyszukiwanie zwróci jeden z nich i model odpowie na podstawie połowy zdania. Jak zwykle w przekonującym, niemal pewnym tonem. Ten problem wraca do tego, co pokazywaliśmy przy złym podziale, tylko tutaj przyczyna jest inna. Fragmenty są poprawne, po prostu granica wypadła w najgorszym możliwym miejscu.
Zachodzenie rozwiązuje to najprostszym sposobem z możliwych. Ogon poprzedniego fragmentu, w naszym przykładzie: ostatnie 150 znaków, trafia na początek następnego fragmentu. Zdanie, które wypadło na granicy podziału, występuje więc w całości przynajmniej raz i wyszukiwanie ma co znaleźć.
Płacisz za to powtórzonym tekstem. Przy 800 znakach na fragment i zachodzeniu 150 znaków, mniej więcej co piąty znak w bazie jest duplikatem. To realny koszt większego zapotrzebowania na pamięć (dysku) oraz w liczbie tokenów wysyłanych do modelu. Jednak w porównaniu z pewną odpowiedzią, która byłaby oparta na połowie zdania – myślę, że warto go ponieść.
Najczęstszy błąd: dzielenie po znaku \n, czyli po pojedynczej nowej linii. W tekstach z twardym zawijaniem daje to fragmenty długości jednej linijki, kompletnie bez kontekstu. Dziel po pustej linii, nie po każdym złamaniu.
Zamiana fragmentów na wektory
Każdy fragment wysyłamy do modelu embeddingowego, a ten zwraca w odpowiedzi listę kilkuset liczb. Taką listę nazywamy wektorem, a liczby w niej są współrzędnymi, dokładnie w tym sensie co szerokość i długość geograficzna na mapie. Różnica polega tylko na tym, że mapa ma dwie współrzędne, a fragment kilkaset.
Skoro każdy fragment ma współrzędne, to każdy jest punktem. Fragmenty o podobnym znaczeniu lądują blisko siebie, a te niemające ze sobą nic wspólnego daleko od siebie.
Brzmi abstrakcyjnie, więc zobaczmy to na prawdziwych danych. Poniżej pięć dokumentów i jedno pytanie, policzone tym samym modelem, którego używamy w kodzie, a potem „spłaszczone” z 768 wymiarów do dwóch, aby dało się je zilustrować:
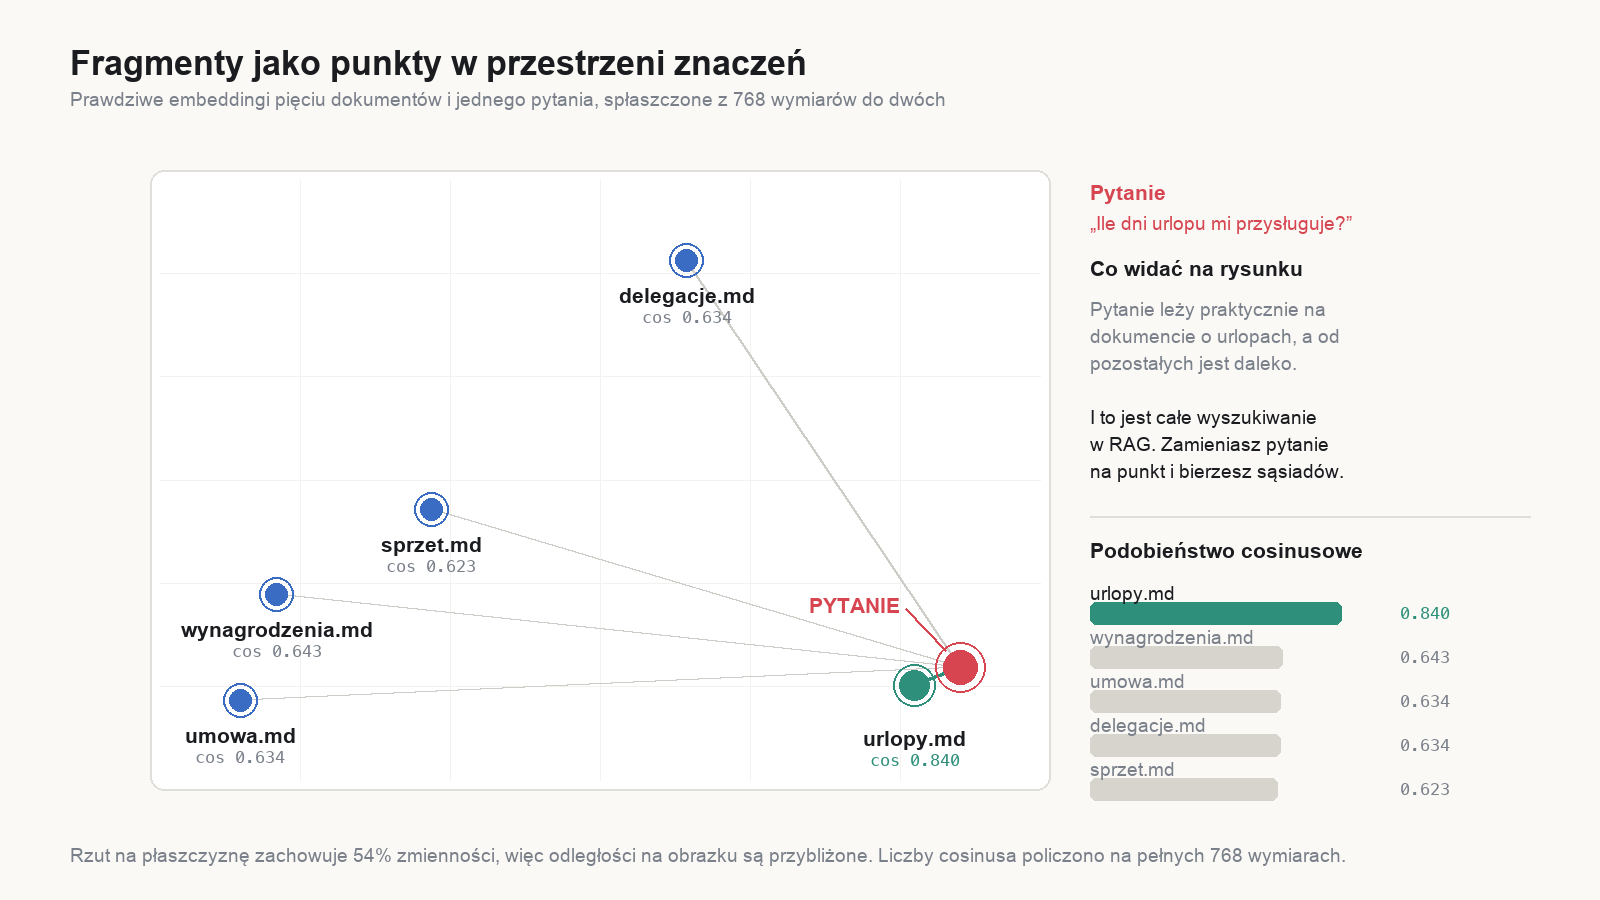
Pytanie o urlop wylądowało bardzo blisko dokumentu o urlopach (urlopy.md), a od pozostałych czterech jest umiejscowione dość daleko. Nikt tego nie ustawiał ręcznie, żadne słowo kluczowe nie zostało dopasowane. Tak po prostu rozłożyły się wektory policzone przez model.
Jedno zastrzeżenie do rysunku. Rzut z 768 wymiarów na płaszczyznę dwu wymiarową zachowuje tylko część informacji, więc odległości na obrazku są przybliżone. Liczby cosinusa obok są natomiast policzone na pełnych wektorach i to one mają znaczenie.
To jest cały mechanizm wyszukiwania. Nasze pytanie, również zamieniamy na punkt, a potem sprawdzamy, które fragmenty leżą najbliżej niego.
Ważna rzecz organizacyjna: model embeddingowy to nie ten sam model, co czatowy. Jest tańszy, mniejszy i robi jedną rzecz. Nie prowadzi rozmowy, a zamienia tekst na wektor.
UWAGA: Od tego miejsca przykłady wywołują API LLMa, więc potrzebujesz klucza (chyba że korzystasz z lokalnego modelu). Każdy dostawca ma własny, a kod niżej korzysta z Gemini. Darmowy klucz wygenerujesz w Google AI Studio pod adresem aistudio.google.com/apikey. Używam Gemini, ponieważ to rozwiązanie działa na darmowym planie. Następnie, pobrany klucz ustawiasz jako zmienną środowiskową, aby biblioteka go przeczytała i abyś nie musiał niczego wpisywać w kodzie.
Na macOS i Linuksie: export GEMINI_API_KEY="twój-klucz". Żeby przetrwało zamknięcie terminala, dopisz tę linię do pliku ~/.zshrc i przeładuj go komendą source ~/.zshrc.
Na Windowsie w PowerShellu: setx GEMINI_API_KEY "twój-klucz", a następnie otwórz nowe okno, bo setx nie działa na bieżącą sesję.
Sprawdzisz to komendą echo ${GEMINI_API_KEY:+ustawiony}. Jeśli zobaczysz słowo „ustawiony”, klucz jest na miejscu. Pusta linia oznacza, że zmiennej nie ma i dostaniesz błąd „No API key was provided”.
Uwaga: NIGDY nie wpisuj klucza na sztywno w pliku .py, zwłaszcza jeśli trzymasz projekt w repozytorium albo w katalogu synchronizowanym z chmurą. Klucz w zmiennej środowiskowej zostaje na Twoim komputerze.
# indeks.py
import sqlite3, json
import numpy as np
from google import genai
from chunking import podziel

MODEL = "gemini-embedding-001"
WYMIARY = 768          # domyślnie model zwraca 3072, patrz akapit niżej
klient = genai.Client()
con = sqlite3.connect("wiedza.db")

con.executescript("""
CREATE TABLE IF NOT EXISTS fragmenty (
    id       INTEGER PRIMARY KEY,
    zrodlo   TEXT NOT NULL,
    tresc    TEXT NOT NULL,
    wektor   TEXT NOT NULL
);
""")

def zaindeksuj(zrodlo, tekst):
    fragmenty = podziel(tekst)
    odp = klient.models.embed_content(
        model=MODEL, contents=fragmenty,
        config={"output_dimensionality": WYMIARY},
    )
    for fragment, dane in zip(fragmenty, odp.embeddings):
        con.execute(
            "INSERT INTO fragmenty (zrodlo, tresc, wektor) VALUES (?, ?, ?)",
            (zrodlo, fragment, json.dumps(dane.values)),
        )
    con.commit()
    print(f"{zrodlo}: {len(fragmenty)} fragmentów")


if __name__ == "__main__":
    DOKUMENTY = {
        "umowa.txt": """Okres wypowiedzenia wynosi trzy miesiące i liczony jest
od pierwszego dnia miesiąca następującego po miesiącu, w którym złożono
wypowiedzenie. Wypowiedzenie wymaga formy pisemnej pod rygorem nieważności.""",

        "urlopy.txt": """Urlop wypoczynkowy przysługuje w wymiarze 26 dni
roboczych w roku kalendarzowym. Wniosek składa się najpóźniej na siedem dni
przed planowanym terminem.""",

        "sprzet.txt": """Laptop służbowy należy zwrócić w dniu zakończenia
współpracy. Za uszkodzenia mechaniczne odpowiada pracownik.""",
    }

    for zrodlo, tekst in DOKUMENTY.items():
        # Kasujemy poprzednią wersję źródła, żeby ponowne uruchomienie
        # nie zdublowało fragmentów w bazie.
        con.execute("DELETE FROM fragmenty WHERE zrodlo = ?", (zrodlo,))
zaindeksuj(zrodlo, tekst)Przeanalizujmy, co ten skrypt robi po uruchomieniu:
Tworzenie bazy i tabeli. sqlite3.connect("wiedza.db") tworzy plik, jeśli jeszcze go nie ma, a CREATE TABLE IF NOT EXISTS przygotowuje tabelę z czterema kolumnami: identyfikator, źródło, treść i wektor. Żadnego serwera bazy nie uruchamiasz, całość generuje jedynie plik bazy danych (zapisany w tym samym katalogu, w którym jest skrypt).
Odczyt dokumentów. W przykładzie są trzy krótkie teksty wpisane wprost w kodzie, żeby dało się go uruchomić bez przygotowań. W prawdziwym systemie w tym miejscu czytasz pliki z dysku albo wpisy z bazy.
Podział na fragmenty. Dokonujemy podziału funkcją podziel() z chunking.py, czyli tą samą, którą omawialiśmy wyżej. Nasze przykładowe teksty mieszczą się w limicie, więc każdy zostaje w jednym kawałku i dlatego po uruchomieniu, zobaczysz 1 fragmentów przy każdym źródle.
Wysyłka fragmentów do modelu embeddingowego i mapowanie na wektory. To jedyny moment, w którym skrypt sięga do internetu, i jedyny, który powiększa Twój rachunek u dostawcy LLM. Cała paczka fragmentów leci w jednym wywołaniu, a nie w osobnym dla każdego.
Zapis do bazy. Każdy wiersz to nazwa źródła, oryginalna treść fragmentu i wektor zapisany jako tekst JSON. Treść trzymamy razem z wektorem, bo przy odpowiadaniu trzeba będzie wkleić do promptu tekst, a nie liczby.
Pętla zaczyna się od DELETE FROM fragmenty WHERE zrodlo = ?, bo bez tego drugie uruchomienie skryptu dołożyłoby do bazy kolejny komplet tych samych fragmentów. Wyszukiwanie zaczęłoby wtedy zwracać duplikaty, a Ty płaciłbyś za ponowne przetworzenie.
Po uruchomieniu zobaczysz trzy linie potwierdzenia, a obok skryptu pojawi się plik wiedza.db. To Twój indeks, gotowy do zadawania pytań.
Zwróć tutaj uwagę na jeden element, bo od niego zależy wysokość rachunku, jaki otrzymasz od dostawcy LLMa: Wektory dla fragmentów liczymy tylko raz, w trakcie indeksowania. Potem leżą one w tabeli fragmenty w pliku wiedza.db i możesz z nich dowolnie korzystać. Zadając pytanie, wysyłasz do modelu wyłącznie samą wiadomość (pytanie, które zadałeś) i dostajesz jeden wektor. Ten jeden wektor porównujesz z wektorami wyciągniętymi z bazy, czyli z tym, co zapisał tam wcześniej skrypt indeks.py.
Wygląda to na oczywiste, ale bardzo łatwo zbudować RAG inaczej i nie zauważyć problemu. Wystarczy, że w kodzie obsługującym pytania wywołasz funkcję zaindeksuj() zamiast sięgnąć po gotowe wektory z bazy. Wtedy każde pytanie użytkownika przelicza od zera cały zbiór dokumentów.
Policzmy to na dziesięciu tysiącach fragmentów i tysiącu pytań.
Poprawnie: dziesięć tysięcy wektorów liczonych raz, przy indeksowaniu, plus jeden wektor na każde zadane pytanie. Razem jedenaście tysięcy wywołań.
Źle: każde z tysiąca pytań przelicza od nowa wszystkie dziesięć tysięcy fragmentów. Tysiąc razy po dziesięć tysięcy, czyli dziesięć milionów wywołań. Prawie tysiąc razy więcej za dokładnie ten sam efekt.
Projekt samej tabeli to osobny temat, większy niż się wydaje. Na potrzeby tego artykułu wystarczą trzy kolumny: źródło, treść i wektor. W prawdziwym systemie szybko dojdą kolejne, czyli data dodania, wersja dokumentu i uprawnienia, bo nie każdy użytkownik ma prawo zobaczyć każdy fragment.
I wtedy wracają problemy, które zna każdy, kto projektował bazę danych. Powtarzać nazwę źródła w każdym wierszu, czy wydzielić osobną tabelę dokumentów i wskazywać na nią kluczem obcym? Dokładnie o tym pisałem w artykule na temat normalizacji baz danych.
Gdzie to trzymać?
Zwykły SQL wystarcza dłużej, niż sądzisz
Powyższy przykład trzyma wektory jako tekst JSON w SQLite i porównuje je w Pythonie. Przy kilku tysiącach fragmentów to działa bez zarzutu i jest zupełnie sensowną decyzją. Struktura tabeli to zwykłe CREATE TABLE, o którym pisałem w artykule o tworzeniu i modyfikacji tabel w SQL.
Ile miejsca zajmuje jeden wektor
Tu czeka niespodzianka, o którą warto zahaczyć, zanim baza urośnie. gemini-embedding-001 domyślnie zwraca 3072 liczby na fragment, co zapisane jako tekst JSON daje około 41 kB. Fragment o długości 109 znaków zajmuje więc w bazie mniej więcej 380 razy więcej miejsca niż jego własna treść.
Dlatego w kodzie wyżej, jest zastosowany parametr output_dimensionality. Daje on nam to, że model zwraca po prostu krótszy wektor.
Warto wiedzieć, co ten parametr faktycznie robi. Model liczy dokładnie to samo co zawsze, a Ty dostajesz tylko początek wyniku. Ustawiając 768, nie prosisz o inny wektor, tylko o pierwsze 768 liczb z tych samych 3072. Oszczędzasz więc miejsce w bazie i czas porównań, ale nie czas pracy modelu, bo on i tak policzył całość.
Nasuwa się pytanie, dlaczego takie obcięcie w ogóle działa? Przy zwykłym embeddingu wyrzucenie trzech czwartych liczb dałoby śmieci, bo informacja o znaczeniu jest w nich rozłożona równomiernie. Ten model jest jednak trenowany metodą matrioszki, czyli tak, żeby wymiary były uporządkowane od najważniejszego. Pierwsze liczby niosą ogólny sens zdania, kolejne dokładają coraz drobniejsze niuanse. Dlatego sam początek wektora nadal jest użyteczny, a Ty decydujesz, ile szczegółów Ci wystarczy.
| Wymiar | Rozmiar w JSON | Trafność na przykładzie z artykułu |
|---|---|---|
| 3072 (domyślnie) | 41 kB | odstęp 0,150 |
| 768 | 10 kB | odstęp 0,166 |
| 256 | 3 kB | odstęp 0,134 |
Kolumna „odstęp” to różnica między najlepszym trafieniem a kolejnym. Im wyższa, tym pewniej właściwy fragment wygrywa z resztą. Czterokrotne zejście z rozmiaru nie pogorszyło tu wyniku, więc 768 wymiarów jest ustawione jako domyślne w przykładach. Na własnym zbiorze warto to sprawdzić to pomiarem. Do tego celu możesz wykorzystać skrypt ocena.py z dalszej części artykułu.
Dwie rzeczy, o których łatwo zapomnieć
Wymiar musi być taki sam przy indeksowaniu i przy pytaniu, bo inaczej nie da się policzyć podobieństwa. Zmieniasz wartość, więc indeksujesz wszystko od nowa. Na szczęście biblioteka NumPy jawnie zgłosi wtedy błąd.
Druga rzecz: wektor o domyślnych 3072 wymiarach jest znormalizowany, ale nie skrócony. Funkcja cosinus z tego artykułu dzieli przez długości wektorów, więc radzi sobie z obydwoma. Gdybyś jednak zobaczył gdzieś poradę, żeby dla przyspieszenia, zastąpić cosinus samym iloczynem skalarnym, to przy skróconych wektorach ta optymalizacja daje złe wyniki.
Kiedy potrzebna jest baza wektorowa
Problem pojawia się przy skali. Porównanie pytania z każdym fragmentem po kolei to złożoność liniowa. Przy stu tysiącach fragmentów każde pytanie oznacza sto tysięcy porównań wektorów po tysiąc kilkaset liczb.
Dedykowane bazy wektorowe rozwiązują to wyszukiwaniem przybliżonym ANN (ang. approximate nearest neighbours). Zamiast porównywać pytanie z każdym fragmentem po kolei, budują wcześniej strukturę, dzięki której da się odrzucić hurtem większość kandydatów bez oglądania ich pojedynczo. To mniej więcej ta sama idea, jak przy wyszukiwaniu binarnym, gdzie jedno porównanie eliminuje połowę zbioru.
Słowo „przybliżone” jest tu jednak istotne i warto je przeczytać dosłownie. Taka struktura potrafi pominąć właściwy fragment, więc płacisz dokładnością za szybkość. Przy stu tysiącach fragmentów to zwykle opłacalna zamiana. Przy tysiącu nie ma czego przyspieszać.
Jeśli już używasz np. PostgreSQL, rozszerzenie pgvector daje typ wektorowy i indeksy w bazie, którą i tak utrzymujesz. To dla większości projektów lepszy krok niż wprowadzanie nowego systemu do stosu technologicznego.
A jeśli nie masz PostgreSQL?
Pozostałe popularne bazy też potrafią już trzymać wektory, tylko każda na swój sposób.
SQLite ma rozszerzenie sqlite-vec. To wariant najbliższy temu, co zbudowaliśmy w tym artykule, bo nie zmieniasz silnika, tylko dokładasz wtyczkę. Rozszerzenie nie ma żadnych zależności i dorzuca wyszukiwanie najbliższych sąsiadów prosto w zapytaniu SQL:
SELECT id, distance FROM moje_wektory WHERE wektor MATCH ?Innymi słowy, pętla po wszystkich wierszach, którą w naszym pytaj.py wykonuje Python, przenosi się do bazy. Zwróć uwagę na jedno: to rozwiązanie w chwili pisania tego tekstu, nie ma jeszcze wydania stabilnego, więc do zastosowań produkcyjnych podchodź ostrożnie.
MariaDB ma wsparcie wbudowane i nie potrzebuje żadnego rozszerzenia. Od wersji 11.8 LTS dostajesz typ VECTOR, osobny VECTOR INDEX oparty na algorytmie HNSW oraz komplet funkcji do liczenia odległości. Niczego nie instalujesz ani nie włączasz, bo to część serwera.
MySQL wymaga uwagi. MySQL 9 wprowadził typ VECTOR, natomiast w darmowej wersji Community dostajesz sam typ danych. Indeksowanie wektorów oraz funkcja licząca odległość, są dostępne wyłącznie w płatnych produktach Oracle. Na zwykłym MySQL wektory więc przechowasz, ale porównywać je i tak będziesz musiał, po swojej stronie, dokładnie jak w naszym przykładzie z SQLite.
Pamiętaj, aby przed finalną implementacją sprawdzić aktualną dokumentację dla swojej bazy danych.
Droga od pytania do odpowiedzi
# pytaj.py
import json
import numpy as np
from google import genai

MODEL = "gemini-embedding-001"
WYMIARY = 768          # MUSI być ta sama wartość co w indeks.py
klient = genai.Client()

def cosinus(a, b):
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))

def znajdz(con, pytanie, ile=4):
    wektor_pytania = np.array(
        klient.models.embed_content(
            model=MODEL, contents=[pytanie],
            config={"output_dimensionality": WYMIARY},
        ).embeddings[0].values
    )
    wyniki = []
    for id_, zrodlo, tresc, wektor in con.execute(
        "SELECT id, zrodlo, tresc, wektor FROM fragmenty"
    ):
        podobienstwo = cosinus(wektor_pytania, np.array(json.loads(wektor)))
        wyniki.append((podobienstwo, zrodlo, tresc))
    wyniki.sort(reverse=True)
    return wyniki[:ile]

def odpowiedz(con, pytanie):
    trafienia = znajdz(con, pytanie)
    kontekst = "\n\n---\n\n".join(
        f"[{zrodlo}]\n{tresc}" for _, zrodlo, tresc in trafienia
    )
    odp = klient.models.generate_content(
        model="gemini-3.6-flash",
        contents=f"Kontekst:\n{kontekst}\n\nPytanie: {pytanie}",
        config={
            "system_instruction": (
                "Odpowiadaj WYŁĄCZNIE na podstawie podanego kontekstu. "
                "Jeśli nie ma w nim odpowiedzi, napisz wprost, że jej nie ma. "
                "Podaj źródło w nawiasie kwadratowym."
            ),
            # Automatic Junction calling to mechanizm, w którym model sam wywołuje funkcje udostępnione mu jako narzędzia.
            # W RAG-u żadnych narzędzi mu nie dajemy, bo kontekst wyszukujemy własnym kodem, więc ten mechanizm jest tu zbędny.
            # Wyłączenie go usuwa też ostrzeżenie, które SDK wypisuje przy każdym wywołaniu i zaśmieca wynik w terminalu.
            "automatic_function_calling": {"disable": True},
        },
    )
    return odp.text


if __name__ == "__main__":
    import sqlite3

    con = sqlite3.connect("wiedza.db")
    PYTANIE = "Jak liczy się okres wypowiedzenia?"

    print(f"Pytanie: {PYTANIE}\n")
    print("Znalezione fragmenty:")
    for podobienstwo, zrodlo, tresc in znajdz(con, PYTANIE):
        podglad = " ".join(tresc.split())[:60]
        print(f"  {podobienstwo:.3f}  [{zrodlo}] {podglad}...")

    print(f"\nOdpowiedź modelu:\n{odpowiedz(con, PYTANIE)}")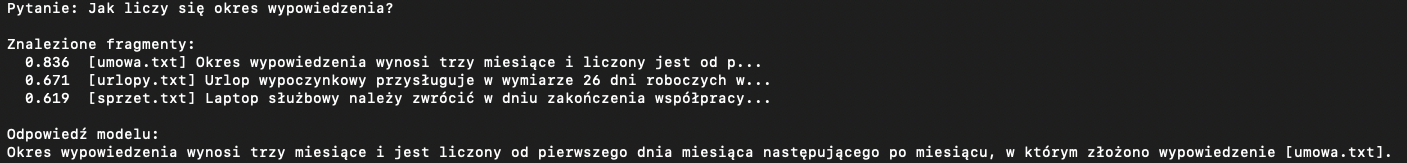
Zwróć uwagę na polecenie systemowe. „Odpowiadaj wyłącznie na podstawie kontekstu” plus jawne pozwolenie na przyznanie się do niewiedzy to najskuteczniejsza pojedyncza linia w całym tym kodzie. Bez niej model chętnie dopełni brakującą wiedzę własną, a Ty nie odróżnisz jednego od drugiego.
UWAGA, WDROŻENIE PRODUKCYJNE: Przykłady w tym artykule uruchamiam na darmowym API Google i to jest w porządku, bo pracujemy na kodzie i danych szkoleniowych. Do produkcji potrzebujesz płatnego planu, z dwóch powodów:
Po pierwsze, darmowy tier ma limity zapytań na minutę i dobę, które przy realnym ruchu skończą się błędem 429.
Po drugie i ważniejsze: dane wysyłane na darmowym tierze Google wykorzystuje do ulepszania swoich modeli, a płatny tier tego nie robi. Nie wysyłaj tam cudzych danych, kodu z prywatnego repozytorium ani niczego objętego umową z klientem.
Warunki dostawców się zmieniają, więc sprawdź je przed wdrożeniem.
TO SAMO U INNYCH DOSTAWCÓW: Oba klocki tego RAG-a, czyli embeddingi i wywołanie czatu z poleceniem systemowym, mają swoje odpowiedniki.
- OpenAI:
embeddings.createz modelemtext-embedding-3-small, a rozmowa przezchat.completions.create, gdzie polecenie systemowe jest po prostu wiadomością o rolisystemna początku listymessages. - Anthropic: rozmowa idzie przez
client.messages.create, a polecenie systemowe NIE jest wiadomością wmessages, tylko osobnym parametremsystemobok listy wiadomości. To najczęstsza pomyłka przy przenoszeniu kodu z OpenAI. Embeddingów Anthropic nie dostarcza i mówi to wprost w dokumentacji, kierując do Voyage AI. Indeks zbudujesz więc modelem innego dostawcy, a Claude zostawisz samo generowanie odpowiedzi.
Sam schemat, czyli podziel, zamień na wektory, znajdź najbliższe, wklej do promptu, jest identyczny wszędzie. Zmienia się wyłącznie warstwa wywołań.
Wariant w pełni lokalny
Jeśli dokumenty nie mogą opuścić Twojej maszyny, ten sam kod może też działać na podstawie modelu lokalnego. Zmienia się adres i nazwa modelu, logika pozostaje ta sama.
Metadane: czyli filtracja przed szukaniem
Technika, która daje największy przyrost trafności przy najmniejszym wysiłku.
Wyszukiwanie po znaczeniu jest przybliżone. Jeśli szukasz w dwustu dokumentach, a wiesz, że odpowiedź jest w umowach, to przeszukiwanie regulaminów i faktur tylko dodaje szansę na trafienie czegoś podobnego, ale nie tego.
Rozwiązanie jest banalne: zawężaj zbiór zwykłym WHERE, zanim policzysz podobieństwo.
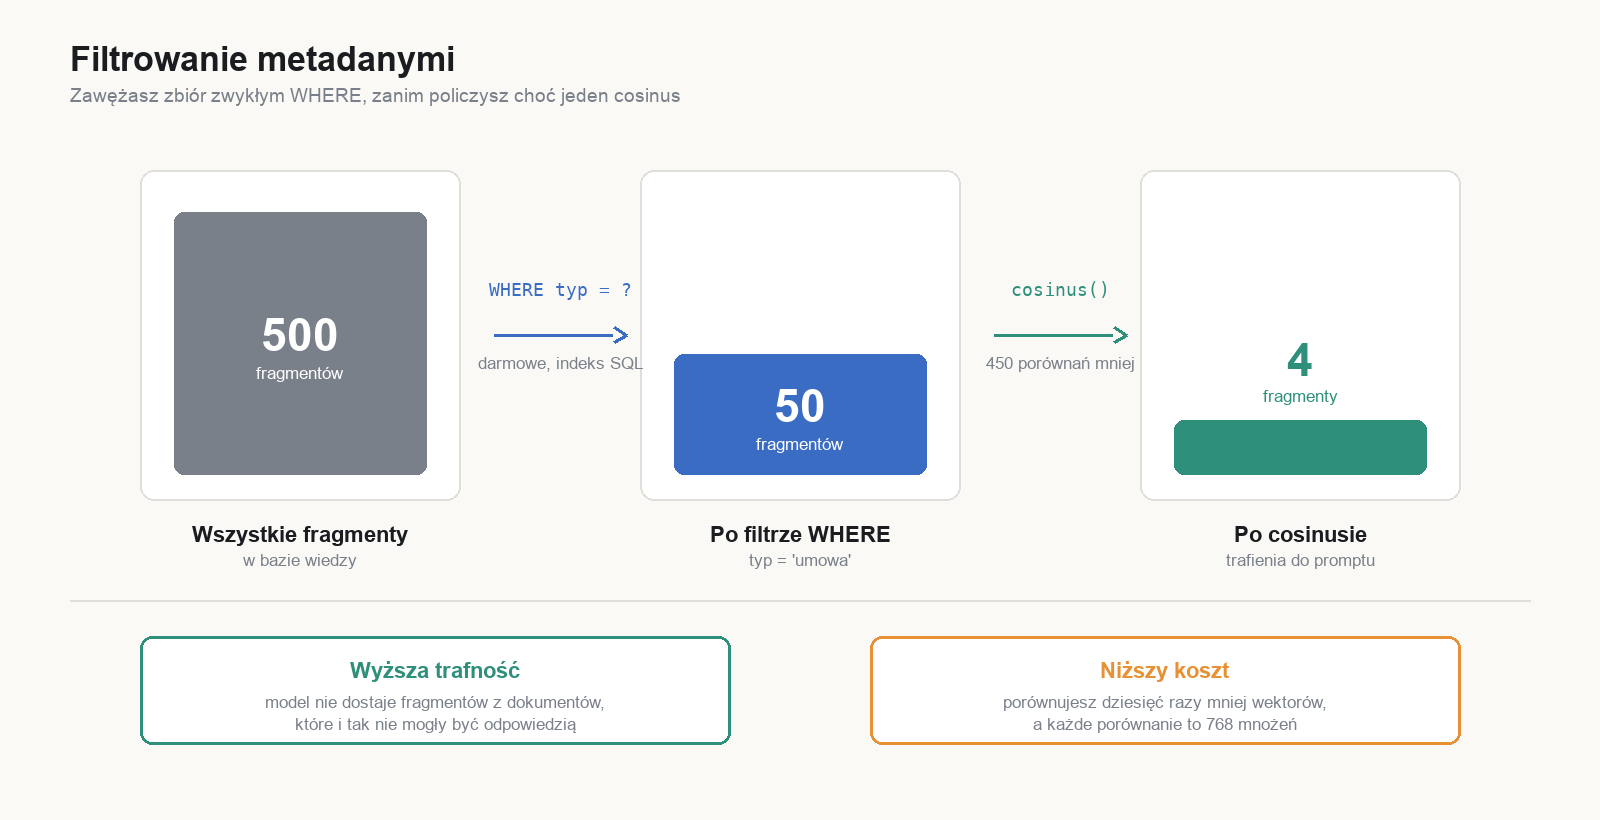
Kolejność ma tu znaczenie. Najpierw odsiewasz bazą, czyli operacją, która na indeksie nic nie kosztuje, a dopiero potem liczysz cosinusy, czyli w naszym przykładzie po 768 mnożeń na każdy pozostały fragment.
con.executescript("""
ALTER TABLE fragmenty ADD COLUMN typ  TEXT;    -- umowa, regulamin, faktura
ALTER TABLE fragmenty ADD COLUMN rok  INTEGER;
CREATE INDEX IF NOT EXISTS idx_typ_rok ON fragmenty (typ, rok);
""")

def znajdz_w(con, pytanie, typ=None, od_roku=None, ile=4):
    warunki, parametry = [], []
    if typ:
        warunki.append("typ = ?");
        parametry.append(typ)
    if od_roku:
        warunki.append("rok >= ?");     parametry.append(od_roku)
    gdzie = f"WHERE {' AND '.join(warunki)}" if warunki else ""
    zapytanie = f"SELECT id, zrodlo, tresc, wektor FROM fragmenty {gdzie}"
# ... dalej jak w znajdz(), tylko na zawężonym zbiorzeTen fragment jest skrócony, bo pokazuje wyłącznie to, co się zmienia. Wyjaśnijmy więc, gdzie dokładnie go wstawić.
Blok executescript uruchamiasz raz, na istniejącej już bazie, bo dokłada kolumny do tabeli założonej wcześniej przez indeks.py. Jedna pułapka: SQLite nie zna składni ALTER TABLE ... ADD COLUMN IF NOT EXISTS, więc drugie uruchomienie tego samego kodu wywali się komunikatem duplicate column name. W gotowym pliku z paczki kodu obchodzę to przechwyceniem wyjątku.
Funkcja znajdz_w() to wariant znajdz() z pytaj.py i tam jest jej miejsce. Różnica sprowadza się do jednej rzeczy. Oryginał ma zapytanie wpisane na sztywno:
for id_, zrodlo, tresc, wektor in con.execute(
    "SELECT id, zrodlo, tresc, wektor FROM fragmenty"
):
a wersja z filtrem podstawia zbudowane wyżej zapytanie wraz z parametrami:
for id_, zrodlo, tresc, wektor in con.execute(zapytanie, parametry):Reszta ciała funkcji, czyli policzenie wektora pytania, pętla po wierszach, cosinus i sortowanie, zostaje bez najmniejszej zmiany. Komentarz # ... dalej jak w znajdz() oznacza dokładnie te linie.
Na koniec trzeba jeszcze wypełnić nowe kolumny, bo indeks.py o nich nie wie i zostawia je puste. Albo dopisujesz UPDATE dla już zaindeksowanych dokumentów, albo, co rozsądniejsze w prawdziwym systemie, rozszerzasz zaindeksuj() o dodatkowe parametry i zapisujesz metadane od razu przy wstawianiu.
Kompletny, działający kod, znajdziesz w paczce z kodem jako filtrowanie.py. Pokazuje on różnicę wprost, na tych samych trzech dokumentach co wcześniej:
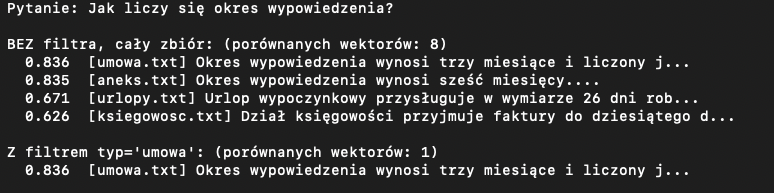
Zysk jest podwójny. Trafność rośnie, bo model nie dostaje fragmentów z dokumentów, które nie mogły być odpowiedzią. Koszt spada, bo porównujesz mniej wektorów.
To zresztą dobra ilustracja tego, że RAG nie zastępuje bazy danych. Metadane, indeksy i WHERE działają dokładnie tak, jak działały zawsze, i warto ich używać.
Wyszukiwanie hybrydowe
Skoro LIKE i embeddingi znajdują różne rzeczy, najlepsze wyniki daje użycie obu naraz i połączenie wyników. To się nazywa wyszukiwaniem hybrydowym i jest dziś domyślnym wyborem w realnych wdrożeniach produkcyjnych.
Powód jest praktyczny. Embeddingi radzą sobie ze znaczeniem, ale tracą pewność przy dokładnych ciągach: numerze faktury, nazwie funkcji, identyfikatorze błędu. Takie ciągi nie niosą znaczenia semantycznego, więc model nie ma się czego uchwycić.
Nowoczesne modele embeddingowe zwykle mimo wszystko zadziałają. Problemem nie jest to, że przegrywają, tylko o ile wygrywają. Przy pytaniu o treść właściwy fragment potrafi odskoczyć od kolejnego o kilkanaście setnych. Przy szukaniu samego numeru faktury ta przewaga spada do kilku setnych, czyli w okolice szumu.
Przy czterech dokumentach to bez znaczenia, bo konkurentów jest tylko trzech i żaden nie zmieści się w tak wąskim przedziale. Przy pięciuset sytuacja się odwraca, choć sam margines wcale się nie kurczy. Rośnie natomiast liczba fragmentów, które mogą się w nim zmieścić. Wystarczy, że cztery przypadkowe trafią w te kilka setnych powyżej właściwego, a ten wypadnie poza czołówkę przekazywaną modelowi. W naszym kodzie to pierwsze cztery wyniki, bo znajdz() ma parametr ile=4. Zwykłe wyszukiwanie po znakach nie ma tego problemu, bo znajduje dokładne dopasowanie zawsze, niezależnie od rozmiaru zbioru. Różnicę zobaczysz na własne oczy w pliku hybrydowo.py z paczki z kodem.
def hybrydowo(con, pytanie, ile=4):
    """Łączy wyniki dwóch metod, każdy fragment liczony raz."""
    semantyczne = znajdz(con, pytanie, ile=ile)
    doslowne = con.execute(
        "SELECT id, zrodlo, tresc FROM fragmenty WHERE tresc LIKE ? LIMIT ?",
        (f"%{pytanie}%", ile),
    ).fetchall()

    razem, widziane = [], set()
    for zestaw in (semantyczne, [(1.0, z, t) for _, z, t in doslowne]):
        for wynik in zestaw:
            klucz = wynik[2][:80]
            if klucz not in widziane:
                widziane.add(klucz)
                razem.append(wynik)
    return razem[:ile]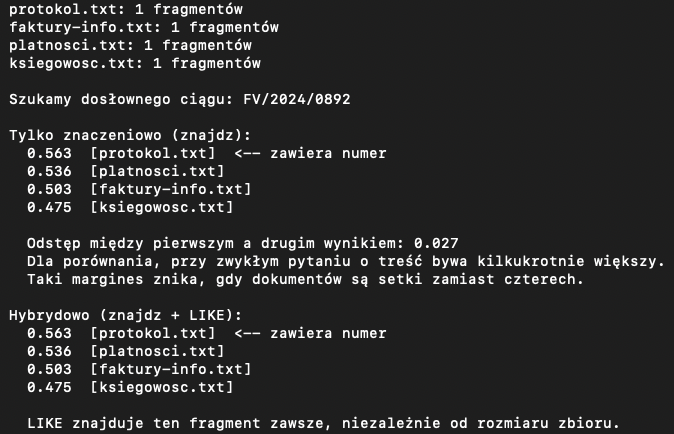
To jest wersja najprostsza z możliwych. Poważniejsze podejścia łączą rankingi wagowo, ale zanim to zrobisz, zmierz, czy prosta suma nie wystarcza. Zwykle wystarcza.
O wyszukiwaniu po znakach z odmianą i rankingiem trafności pisałem w artykule o wyszukiwaniu pełnotekstowym w MySQL i to jest naturalny drugi składnik hybrydy, lepszy od zwykłego LIKE.
Ile fragmentów podawać
Mowa o parametrze ile z funkcji znajdz(), czyli o tym, ile najlepszych fragmentów trafia do promptu. Wygląda na drobiazg, a ma zaskakująco duży wpływ na jakość odpowiedzi.
Odruch podpowiada „więcej kontekstu, lepsza odpowiedź”. W praktyce każdy dodatkowy fragment to również szum, a modele gubią się przy długich danych wejściowych: najlepiej wykorzystują początek i koniec, a środek traktują pobieżnie.
W praktyce sugeruję, aby zacząć od trzech albo czterech fragmentów i sprawdzić na swoim zbiorze testowym, czy zwiększanie tego parametru pomaga. Bardzo często nie pomaga, a czasem nawet szkodzi.
Jest jeszcze jedna sztuczka, tania i skuteczna: najtrafniejszy fragment umieść na końcu kontekstu, bezpośrednio przed pytaniem. Wynika to wprost z tego, jak modele traktują pozycję na wejściu, i nie wymaga żadnej zmiany w wyszukiwaniu, tylko odwrócenia kolejności przy składaniu promptu.
Zobaczmy to na naszym przykładzie. Funkcja znajdz() zwraca trafienia posortowane malejąco, więc najlepsze idzie na początek. Dla pytania o okres wypowiedzenia wyniki to kolejno 0,836, 0,671 i 0,619, a prompt wygląda tak:
[umowa.txt]
Okres wypowiedzenia wynosi trzy miesiące i liczony jest...     <- najtrafniejszy
---
[urlopy.txt]
Urlop wypoczynkowy przysługuje w wymiarze 26 dni...
---
[sprzet.txt]
Laptop służbowy należy zwrócić w dniu zakończenia...

Pytanie: Jak liczy się okres wypowiedzenia?
Najważniejszy fragment leży najdalej od pytania, czyli dokładnie tam, gdzie model czyta najmniej uważnie. Poprawka to jedno słowo w odpowiedz():
    kontekst = "\n\n---\n\n".join(
        f"[{zrodlo}]\n{tresc}" for _, zrodlo, tresc in reversed(trafienia)
    )
Po tej zmianie kolejność jest odwrotna:
[sprzet.txt]
Laptop służbowy należy zwrócić w dniu zakończenia...
---
[urlopy.txt]
Urlop wypoczynkowy przysługuje w wymiarze 26 dni...
---
[umowa.txt]
Okres wypowiedzenia wynosi trzy miesiące i liczony jest...     <- najtrafniejszy

Pytanie: Jak liczy się okres wypowiedzenia?
Do modelu trafiają te same trzy fragmenty i ten sam koszt w tokenach. Zmienia się wyłącznie to, że najtrafniejszy sąsiaduje bezpośrednio z pytaniem.
Skąd wiemy, że to działa?
Zła odpowiedź z RAG-a zawsze wygląda tak samo. Model odpowiada pewnie i składnie, tylko nie na temat. Po samej odpowiedzi nie poznasz, czy zawiodło wyszukiwanie, podział dokumentów, czy prompt. A każdą z tych rzeczy naprawia się inaczej.
Dlatego potrzebny jest pomiar.
Zbiór testowy, dwadzieścia pytań
Wypisz dwadzieścia realnych pytań i dla każdego zaznacz, który fragment powinien się znaleźć w kontekście.
Kompletny zbiór dwudziestu pytań wraz z ośmioma dokumentami, na których go zmierzyłem, znajdziesz w paczce z kodem jako ocena.py. Szesnaście pytań jest jednoznacznych, a cztery celowo pasują do kilku dokumentów naraz. Skrypt wypisuje każde pudło, a na końcu podsumowanie, i robi to dla dwóch ustawień naraz:
# ocena.py
PRZYPADKI = [
    ("która umowa dotyczy hostingu?", "umowa-hosting.md"),
    ("jaki jest okres wypowiedzenia?", "umowa-hosting.md"),
    # ... 18 kolejnych
]

def zmierz(con):
    trafione = 0
    for pytanie, oczekiwane_zrodlo in PRZYPADKI:
        zrodla = [z for _, z, _ in znajdz(con, pytanie)]
        if oczekiwane_zrodlo in zrodla:
            trafione += 1
        else:
            print(f"PUDŁO: {pytanie}\n  dostałem: {zrodla}")
    print(f"\ntrafność wyszukiwania: {trafione}/{len(PRZYPADKI)}")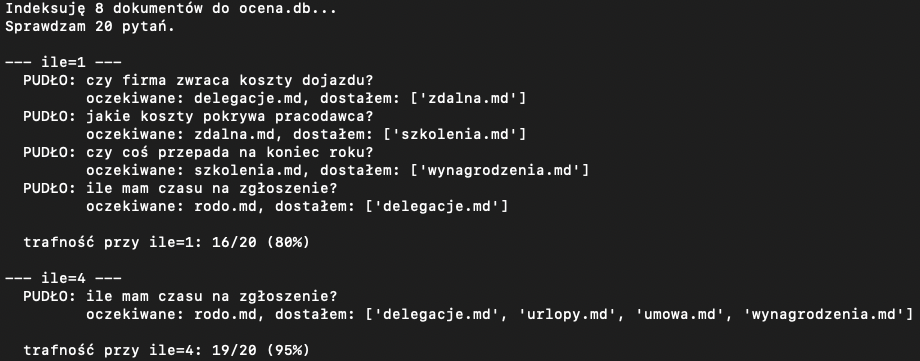
Popatrz na dwie ostatnie linie każdej sekcji. Przy jednym podawanym fragmencie trafność wynosi 16 na 20, przy czterech rośnie do 19 na 20. Trzy pytania, które wcześniej były pudłami, zostają uratowane wyłącznie dzięki zmianie jednej liczby w kodzie. To jest dokładnie ten pomiar, na podstawie którego dobiera się wartość parametru ile, zamiast przyjmować ją z sufitu.
Ciekawsze jest jednak to jedno pytanie, które nie przechodzi w żadnym z ustawień. Przy ile=4 wyszukiwanie zwróciło cztery różne dokumenty: o delegacjach, urlopach, umowie i wynagrodzeniach. Każdy z nich mówi o jakimś terminie, więc żaden nie jest głupim trafieniem.
I to jest cenna informacja, bo problem nie leży tu w RAG-u. Pytanie „ile mam czasu na zgłoszenie?” po prostu nie mówi, o jakie zgłoszenie chodzi. Bez zbioru testowego uznałbyś to za błąd wyszukiwania i szukałbyś rozwiązania nie tam, gdzie trzeba.
Trzy przyczyny złych odpowiedzi
Właściwy fragment nie trafił do kontekstu. Problem jest w wyszukiwaniu albo w podziale. Sprawdź, czy fragment w ogóle istnieje w całości, lub czy nie został przycięty.
Fragment trafił, a odpowiedź jest zła. Problem jest w prompcie albo w modelu, nie w RAG.
Fragment trafił, ale razem z trzema niepotrzebnymi. Problem jest w liczbie zwracanych fragmentów. Więcej nie znaczy lepiej, bo szum rozprasza model.
Aktualizacja dokumentów
Kiedy budujesz RAG po raz pierwszy, robisz to zwykle na zbiorze, który stoi w miejscu. Wrzucasz dokumenty, indeksujesz je raz i wszystko działa. Problem pojawia się później, gdy te dokumenty zaczynają „żyć”.
Naiwne podejście to przeliczenie wszystkiego od nowa po każdej zmianie. Przy dwustu dokumentach to minuty i koszty embeddingu.
Tańsze rozwiązanie polega na trzymaniu odcisku treści i przeliczaniu wyłącznie tego, co się zmieniło.
import hashlib

def odcisk(tekst):
    return hashlib.sha256(tekst.encode()).hexdigest()[:16]

def zaindeksuj_jesli_zmienione(con, zrodlo, tekst):
    nowy = odcisk(tekst)
    stary = con.execute(
        "SELECT odcisk FROM dokumenty WHERE zrodlo = ?", (zrodlo,)
    ).fetchone()

    if stary and stary[0] == nowy:
        return "bez zmian"

    con.execute("DELETE FROM fragmenty WHERE zrodlo = ?", (zrodlo,))
    zaindeksuj(zrodlo, tekst)
    con.execute(
        "INSERT INTO dokumenty (zrodlo, odcisk) VALUES (?, ?) "
        "ON CONFLICT(zrodlo) DO UPDATE SET odcisk = excluded.odcisk",
        (zrodlo, nowy),
    )
    con.commit()
return "zaktualizowane"Powyższy fragment pomija jedną rzecz, potrzebną do uruchomienia. Odciski trzymamy w osobnej tabeli dokumenty, której indeks.py nie zakłada, bo tworzy tylko fragmenty. Trzeba ją więc dodać:
CREATE TABLE IF NOT EXISTS dokumenty (
    zrodlo  TEXT PRIMARY KEY,
    odcisk  TEXT NOT NULL
);
Klucz główny na zrodlo jest tu istotny, bo to dzięki niemu działa ON CONFLICT w kodzie wyżej. Bez niego każde ponowne indeksowanie dokładałoby kolejny wiersz, zamiast nadpisywać istniejący.
Kompletny przykład do uruchomienia lokalnie, znajdziesz w paczce z kodem w pliku przyrostowo.py. Pokazuje on trzy sytuacje z rzędu: dokument nowy, ten sam dokument bez zmian i ten sam dokument po edycji:
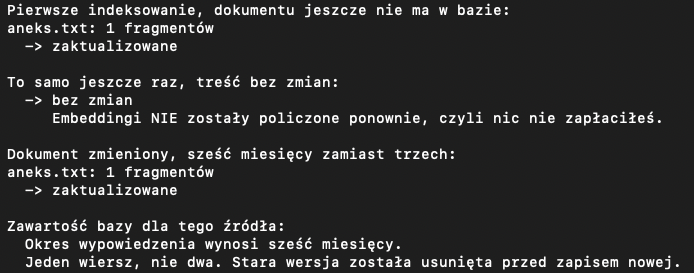
Zwróć uwagę na DELETE przed ponownym indeksowaniem. Bez niego stare fragmenty zostają w bazie obok nowych i model dostaje dwie wersje tego samego dokumentu, często sprzeczne. To jeden z najbardziej mylących błędów w RAG, bo odpowiedzi są prawie dobre i trudno dojść, skąd biorą się rozbieżności. W przyrostowo.py widać to na końcu wprost: po zmianie treści w bazie zostaje jeden wiersz, nie dwa.
Usuwanie dokumentów
Ta sama pułapka od drugiej strony. Dokument usunięty ze źródła nie znika z indeksu sam. Będzie dalej trafiał do kontekstu i model będzie na niego powoływał się jako na obowiązujący.
Jeśli indeksujesz katalog, po każdym przebiegu usuwaj z bazy fragmenty, których źródła już nie ma. To naprawdę jedno zapytanie, a ratuje przed najgorszym rodzajem błędu, czyli pewną odpowiedzią opartą na nieaktualnym dokumencie.
def usun_osierocone(con, aktualne_zrodla):
    """Usuwa fragmenty tych źródeł, których nie ma już w katalogu.
    `aktualne_zrodla` to lista nazw plików z BIEŻĄCEGO przebiegu."""
    znaki = ",".join("?" * len(aktualne_zrodla))
    usuniete = con.execute(
        f"DELETE FROM fragmenty WHERE zrodlo NOT IN ({znaki})",
        list(aktualne_zrodla),
    ).rowcount
    con.execute(
        f"DELETE FROM dokumenty WHERE zrodlo NOT IN ({znaki})",
        list(aktualne_zrodla),
    )
    con.commit()
return usunieteWywołujesz to raz, na końcu indeksowania, podając listę plików, które faktycznie znalazłeś w katalogu. Wszystko, czego na tej liście nie ma, wylatuje z bazy razem z rekordem w tabeli odcisków.
Dwie rzeczy warte uwagi. Liczba znaków zapytania budowana jest z długości listy, bo NOT IN nie przyjmuje jednego parametru z całą kolekcją. Same wartości idą jednak nadal jako parametry, nie przez sklejanie tekstu, więc o wstrzyknięcie SQL można być spokojnym.
Drugą rzeczą jest przypadek pustego katalogu. Wtedy NOT IN () jest niepoprawnym SQL-em i zapytanie się wysypie, więc wersja w paczce obsługuje to osobno, czyszcząc całą tabelę. Brzmi jak drobiazg, ale to dokładnie ten scenariusz, który zdarza się przy literówce w ścieżce do katalogu.
RAG, a to, co już znasz z SQL
Zestawienie, które warto mieć w głowie, bo pokazuje, że RAG nie zastępuje wyszukiwania, tylko je uzupełnia.
| Metoda | Znajduje | Nie znajduje | Koszt |
|---|---|---|---|
LIKE '%słowo%' | dokładne wystąpienia znaków | synonimów, parafraz | znikomy |
| wyszukiwanie pełnotekstowe | słowa z odmianą, ranking trafności | znaczeń wyrażonych inaczej | niski |
| RAG na embeddingach | bliskie znaczeniowo, choć inaczej nazwane | wymaga wywołania modelu, myli podobnie brzmiące | średni |
O LIKE pisałem w artykule o przeszukiwaniu danych tym operatorem, a o drugiej metodzie w tekście o wyszukiwaniu pełnotekstowym w MySQL. Jeśli szukasz na przykład numeru faktury, LIKE będzie lepszy od RAG pod każdym względem. Dobre systemy łączą metody i wybierają odpowiednią zależnie od pytania.
Jak z tego skorzystać na własnych dokumentach
Przykłady w tym artykule mają dane wpisane wprost w kodzie, żeby dało się je uruchomić bez żadnych przygotowań. W praktyce chcesz czegoś innego, czyli własnego katalogu z plikami. Zmiana jest mniejsza, niż mogłoby się wydawać.
Potrzebujesz trzech plików: chunking.py dzieli dokumenty, indeks.py buduje bazę, pytaj.py odpowiada na pytania. Cała reszta z paczki to rozszerzenia, po które sięgasz wtedy, gdy napotkasz problem, który rozwiązują.
Krok pierwszy: wskaż swój katalog. Zamiast słownika z przykładowymi tekstami wczytujesz pliki z dysku:
# zaindeksuj_katalog.py
import pathlib

from indeks import zaindeksuj, con

KATALOG = pathlib.Path("moje-dokumenty")

for sciezka in sorted(KATALOG.glob("*.md")):
    con.execute("DELETE FROM fragmenty WHERE zrodlo = ?", (sciezka.name,))
zaindeksuj(sciezka.name, sciezka.read_text(encoding="utf-8"))DELETE przed każdym plikiem sprawia, że skrypt możesz uruchamiać wielokrotnie bez dublowania fragmentów w bazie. Rozszerzenie *.md zmień na swoje, a jeśli masz podkatalogi, użyj rglob zamiast glob.
Krok drugi: zadaj pytanie. Od tego momentu korzystasz z odpowiedz() bez żadnych zmian:
import sqlite3
from pytaj import odpowiedz

con = sqlite3.connect("wiedza.db")
print(odpowiedz(con, "Ile dni urlopu mi przysługuje?"))
Na trzech plikach z moim testowym katalogiem odpowiedź wyglądała tak:
Przysługuje Ci 26 dni roboczych urlopu wypoczynkowego [urlopy.md].Nazwa pliku w nawiasie kwadratowym to zasługa polecenia systemowego. Dzięki niej zawsze wiesz, skąd wzięła się odpowiedź, i możesz ją sprawdzić.
Co dalej, czyli kiedy sięgać po dodatkowe rozszerzenia? Kolejność jest tu istotna, bo każde z nich rozwiązuje inny problem i nie ma sensu dokładać ich zawczasu.
Zacznij od ocena.py, czyli od zbioru testowego na własnych pytaniach. Bez niego nie zobaczysz efektu żadnej kolejnej zmiany. Gdy dokumenty zaczną się zmieniać, dołóż przyrostowo.py, bo bez niego płacisz za przeliczanie tego samego i ryzykujesz dwie wersje dokumentu w bazie naraz. Jeśli trafność siada przy dużym zbiorze, spróbuj filtrowanie.py i zawężaj wyszukiwanie metadanymi. A gdy użytkownicy szukają numerów faktur, identyfikatorów i nazw własnych, dołóż hybrydowo.py.
Zanim zdecydujesz się na wdrożenie produkcyjne, wróć do dwóch rzeczy z tego artykułu. Klucz API trzymaj w zmiennej środowiskowej, nigdy w kodzie ani w repozytorium. Darmowy tier Google nadaje się do nauki i do własnych plików, ale nie do cudzych danych, bo na nim dostawca wykorzystuje przesłane treści do ulepszania modeli.
Wszystkie skrypty z artykułu razem z plikiem tokenizer.model, plikiem requirements.txt i krótkim README znajdziesz w jednej paczce:
Jeśli zbudujesz to u siebie, koniecznie daj znać w komentarzu, na jakim zbiorze i z jaką trafnością dostajesz wyniki. Powodzenia!

 Łukasz Dudziński2026-11-05 · 4 min
 Łukasz Dudziński2026-10-22 · 13 min
 Łukasz Dudziński2026-10-08 · 9 min
// brak komentarzy — bądź pierwszy